




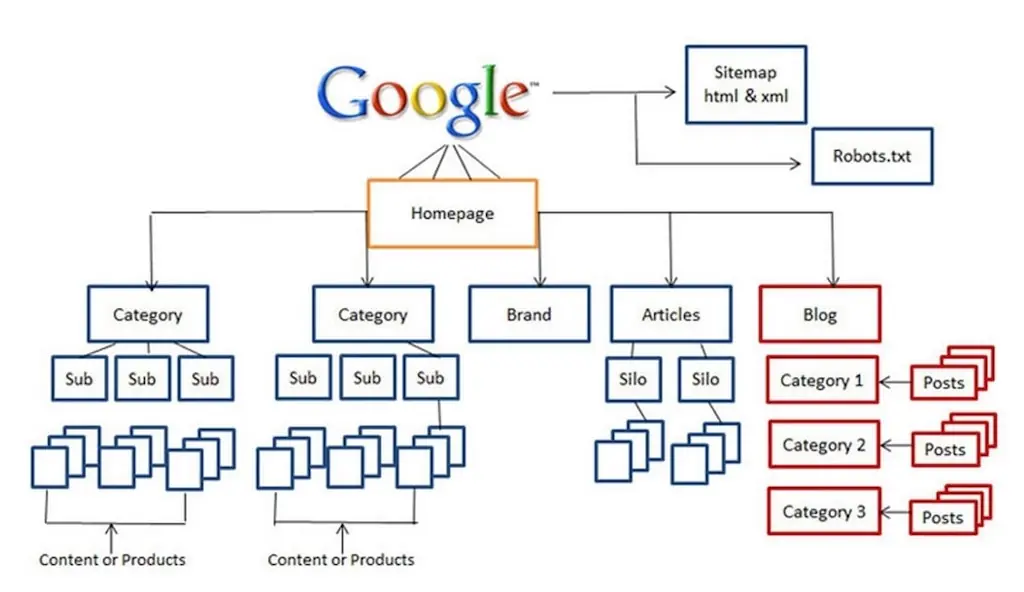

Архитектура сайта отвечает на один практический вопрос: дойдёт ли робот до вашей страницы, за сколько шагов он это сделает и поймёт ли по дороге, что за документ перед ним. Всё остальное — вложенность, шаблоны, адреса, коды ответа, файлы на сервере — служит этому вопросу. Когда сайт годами не выходит из третьей десятки при нормальных текстах и живых ссылках, причина чаще всего лежит именно здесь: страница есть, а добраться до неё дорого, и поисковик просто перестаёт тратить на неё обходы.
В SEO я с 2005 года и за это время видел, как одна и та же ошибка каркаса убивает бюджет на контент. Сайт наполняют, статьи выходят, а в поиске оказывается четверть из них. Дальше владелец докупает ссылки, меняет копирайтера, переписывает title — и ничего не меняется, потому что проблема не в тексте, а в том, как устроен путь к нему. Ниже — как разложить архитектуру на проверяемые части и что с каждой делать.
Где заканчивается архитектура и начинается структура разделов
Два понятия постоянно путают, и из-за этой путаницы аудит получается половинчатым. Структура разделов — про смысл: какие категории есть у каталога, как группируется спрос, куда посадить запрос «купить дубовую доску» и куда «доска обрезная оптом». Архитектура — про каркас: сколько уровней у сайта физически, какие шаблоны отдают страницы, как выглядят адреса, что лежит на сервере, какие коды возвращает сервер и что из этого видит краулер.
Разница не терминологическая. Ошибку в структуре разделов исправляет семантика и работа с посадочными страницами. Ошибку в архитектуре исправляет разработчик, и стоит она дороже, потому что тянет за собой шаблоны, адреса и редиректы. Поэтому разбирать их надо порознь: сначала убедиться, что каркас исправен, и только потом обсуждать, правильно ли поделён каталог.
| Вопрос | Архитектура (каркас) | Структура разделов (смысл) |
|---|---|---|
| Кто чинит | Разработчик, системный администратор | SEO-специалист, контент-менеджер |
| Единица работы | Шаблон, URL, код ответа, файл | Раздел, посадочная страница, группа запросов |
| Типичный дефект | Страница недостижима, дубль по параметру, шаблон без h1 | Нет страницы под коммерческий запрос, две страницы конкурируют |
| Как обнаруживается | Краулер, логи сервера, отчёты Вебмастера об обходе | Сбор семантики, анализ выдачи, карта релевантности |
| Цена ошибки | Правки в коде и массовые редиректы | Переписывание текстов и перелинковки |
Вложенность и кликовая глубина: сколько шагов до страницы
Есть два разных измерения глубины, и путать их нельзя. Первое — вложенность в адресе: сколько сегментов в URL после домена. Второе — кликовая глубина: минимальное число переходов по внутренним ссылкам от главной до этой страницы. Робот ходит по ссылкам, поэтому для обхода значение имеет второе, а не первое. Страница с адресом из четырёх сегментов, на которую есть ссылка с главной, будет обходиться чаще, чем страница с плоским адресом, к которой ведёт только семнадцатая страница пагинации.
Старое правило «два уровня» из статей десятилетней давности давно неверно в буквальном прочтении: и Яндекс, и Google обходят сколь угодно глубокие сайты. Верно другое — с ростом кликовой глубины падает частота обхода и приоритет страницы во внутреннем распределении веса. Страница на седьмом уровне не исчезает из индекса, она просто переиндексируется раз в несколько месяцев, и обновление цены на ней доедет до выдачи не скоро.
| Кликовая глубина | Что обычно там лежит | Поведение робота | Что делать |
|---|---|---|---|
| 1 | Главная, ключевые разделы, услуги | Обход почти ежедневно | Держать здесь то, что приносит деньги |
| 2–3 | Категории, карточки, статьи | Регулярный обход, быстрое обновление | Рабочая зона, целевая для большинства страниц |
| 4–5 | Подкатегории, глубокие фильтры, архивы | Обход реже, обновления доезжают с задержкой | Сокращать ссылками из хабов и блоков «смотрите также» |
| 6 и глубже | Хвост пагинации, старые записи, комбинации фильтров | Единичные заходы, часть страниц не в поиске | Либо поднимать перелинковкой, либо закрывать от индексации |
Проверяется это за час. Запустите любой десктопный краулер, дайте ему обойти сайт от главной и постройте распределение страниц по колонке с глубиной. Если у интернет-магазина половина карточек оказывается на пятом уровне и глубже — это не «особенность каталога», а прямая причина того, почему товарные запросы не растут. Лечится добавлением хабовых страниц, ссылками на популярные подборки из шапки и подвала, а также блоками перелинковки внутри карточек.

Отдельно про пагинацию. Классическая схема «первая, предыдущая, следующая, последняя» загоняет середину списка на огромную глубину: до сотой страницы робот идёт сотней переходов. Схема с числовыми блоками и скачками через десяток сокращает путь до нескольких шагов. Это дешёвая правка шаблона, которая заметно меняет полноту индекса на больших каталогах.
URL как часть каркаса
Адрес страницы — не косметика, а идентификатор документа. Все проблемы дублирования начинаются с того, что один и тот же контент доступен по нескольким адресам, и поисковик вынужден выбирать, какой из них считать главным. Выбирает он не всегда так, как вы рассчитывали.
Смежный материал по теме — «Бесплатное продвижение сайта в поисковиках».
- Один протокол и один хост. http и https, с www и без — это четыре разных адреса. Должен работать один, остальные три отдают 301 на него. Проверяется вручную за минуту через любой сервис проверки заголовков.
- Один вариант слеша. Адрес с завершающим слешем и без него — разные URL. Выберите один формат и приведите к нему шаблоны, sitemap и внутренние ссылки.
- Нижний регистр. Сервер под Linux различает регистр в путях. Ссылка на /Katalog/ и /katalog/ — два документа, из которых один может отдавать 404.
- Латиница и транслитерация. Кириллица в адресе работает, но в отчётах и ссылках превращается в процентные последовательности, что усложняет анализ. Транслитерация надёжнее в эксплуатации.
- Без идентификаторов сессий и лишних параметров. Параметры сортировки, отображения, utm-меток плодят копии. Каноническая ссылка на чистый адрес и правила в robots.txt — обязательная часть шаблона, а не разовая правка.
Про смену адресов главное правило простое: массовое переименование URL — это всегда потеря части накопленного, даже при идеально настроенных редиректах. Переезд имеет смысл, когда старые адреса технически мешают (например, содержат идентификаторы сессий), и не имеет смысла ради красоты. Если менять всё же приходится, готовьте карту соответствия «старый адрес — новый адрес» построчно, а не правилом с подстановкой: правило почти всегда даёт цепочки редиректов и промахи на исключениях.
Шаблоны страниц: где каркас соприкасается с текстом
Помогу с продвижением: продвижение бизнеса в Яндексе — вывожу сайты в топ Яндекса белыми методами.
Любой сайт на CMS собирается из ограниченного числа шаблонов. Даже у магазина с сотней тысяч товаров шаблонов будет штук десять: главная, категория, карточка, поиск, статья, список статей, контакты, корзина, страница ошибки, служебные. Всё, что вы правите в шаблоне, умножается на число страниц этого типа. Всё, что в шаблоне сломано, тоже умножается.
Разбор шаблонов даёт самый быстрый эффект в техническом аудите, потому что одна правка закрывает тысячи страниц. Поэтому в аудите я всегда прошу список шаблонов и по одному образцу каждого, а не выгрузку всех URL — по выгрузке те же дефекты придётся вылавливать по одному.
Если интересно направление с сайтами — базу даю в своём курсе:
| Шаблон | Задача в поиске | Что проверять в первую очередь |
|---|---|---|
| Категория каталога | Собирает общий и средний спрос | Один h1, текст не выше листинга, пагинация с канониклами, фильтры не плодят дубли |
| Карточка товара | Низкочастотный и брендовый спрос | Уникальный title, наличие цены и характеристик в html, доступность без JavaScript |
| Статья блога | Информационный спрос, вход в воронку | Дата изменения, хлебные крошки, блок перехода к услуге |
| Страница поиска по сайту | Не нужна в индексе | Закрыта в robots.txt, ссылки на неё не расходуют вес |
| Страница ошибки | Гасит битые адреса | Код 404, а не 200; ссылки на разделы; не редирект на главную |

Последняя строка — самая частая находка. Многие CMS и темы отдают несуществующему адресу красивую страницу «ничего не найдено» с кодом 200. Для робота это означает, что по адресу /katalog/oshibka-v-ssylke/ есть документ, и он добавляет его в очередь обхода. На сайте с активной перелинковкой такие мнимые страницы копятся сотнями и размывают обход. Проверяется одним запросом: откройте заведомо несуществующий адрес и посмотрите заголовок ответа — там должно быть 404 или 410.
Что реально видит краулер
Робот получает не картинку, а исходный код. Дальше он может выполнить JavaScript и увидеть то, что дорисовал скрипт, но делает это отложенно и не для всех страниц. Практический вывод: всё, что важно для ранжирования, должно присутствовать в html до выполнения скриптов — заголовок, основной текст, цена, ссылки на другие страницы.
Если нужны детали, смотрите «Самостоятельное SEO продвижение сайта».
- Навигация на скриптах. Если меню собирается на клиенте и в исходном коде ссылок нет, робот их не пройдёт, а кликовая глубина всего сайта окажется бесконечной. Ссылка должна быть тегом a с атрибутом href, а не элементом с обработчиком клика.
- Подгрузка по кнопке «показать ещё». Товары, которые появляются только после нажатия, для робота не существуют. Нужен дублирующий путь: обычная пагинация ссылками, доступная без скриптов.
- Ленивая загрузка изображений. Допустима, если у картинки есть корректный src или атрибуты, которые понимает браузер нативно. Самописные варианты, где реальный адрес лежит в произвольном атрибуте, для поиска картинок бесполезны.
- Текст в изображениях. Ровно та же история, что двадцать лет назад: то, что нарисовано на картинке, поисковик не читает. Атрибут alt описывает изображение и помогает поиску по картинкам, но не заменяет текст на странице.
- Контент за интерактивом. Спойлеры и вкладки — нормально, если содержимое лежит в коде и просто скрыто стилями. Плохо, когда оно подгружается запросом только по клику.
Проверить это просто: откройте исходный код страницы сочетанием клавиш и поищите в нём фрагмент вашего текста и адреса из меню. Если не находится — робот в первом проходе тоже не найдёт. Второй способ точнее: инструмент проверки страницы в Яндекс Вебмастере показывает, каким сервер отдал документ роботу, без влияния браузера и кэша.
Файлы и каталоги на сервере
Физическая часть каркаса — то, как разложены файлы. Она реже становится причиной провала, но регулярно даёт неприятные мелочи, которые никто не ищет, потому что смотрят только на страницы.
- Открытые служебные каталоги. Если по адресу папки отдаётся список файлов, в индекс попадают резервные копии, архивы и черновики. Листинг каталогов отключается настройкой сервера.
- Старые копии сайта в подпапках. Каталог /old/ или /new/ с рабочей копией — это второй сайт на том же домене, с полным дублированием контента. Такие копии закрываются паролем на уровне сервера, а не строчкой в robots.txt.
- Тестовые поддомены. Открытая для индексации версия на dev-поддомене конкурирует с боевой. Закрывать доступом по паролю, иначе рано или поздно она попадёт в выдачу.
- Файлы без ссылок. Прайсы, презентации, старые версии документов на сервере доступны роботу, если на них когда-то ссылались. Такой мусор надо инвентаризировать хотя бы раз в год.

Служебные узлы: robots.txt, sitemap.xml, коды ответа
Эти три вещи задают правила игры для робота, и почти всегда в них есть хотя бы одна ошибка, потому что настраивали их однажды и больше не открывали.
robots.txt. Файл запрещает обход, а не индексацию. Страница, закрытая в robots.txt, но получившая внешние ссылки, может показаться в выдаче без описания. Чтобы страницы точно не было в поиске, используется мета-тег robots со значением noindex, и для этого страница должна быть открыта для обхода — иначе робот не увидит указание. Самая дорогая ошибка тут — Disallow, оставшийся после разработки: сайт живёт, страницы уходят из индекса, а причина в одной строке.
Если нужна помощь по теме — купить SEO-статьи.
sitemap.xml. Карта нужна не для «улучшения индексации», а чтобы сообщить о страницах, до которых трудно дойти по ссылкам, и передать дату последнего изменения. Отсюда требования: в карте только страницы с кодом 200, доступные для индексации, с честной датой изменения. Карта, где у всех страниц одна и та же дата или дата генерации файла, бесполезна — по ней невозможно понять, что обновилось.
Коды ответа. Это язык, на котором сервер разговаривает с роботом. Ошибка в кодах даёт эффекты, которые потом объясняют «фильтрами».
Подробнее об этом — в статье «Оптимизация сайта под мобильные устройства».
| Код | Когда уместен | Частая ошибка |
|---|---|---|
| 200 | Рабочая страница | Отдаётся несуществующим адресам и страницам ошибки |
| 301 | Адрес сменился навсегда | Цепочки из трёх-четырёх переходов, редирект всего подряд на главную |
| 302 | Временная подмена | Ставят вместо 301 при переезде — старый адрес остаётся основным |
| 404 | Страницы нет и не будет | Отдают 200 или редирект, из-за чего мусорные адреса живут годами |
| 410 | Страница удалена сознательно | Не используют вовсе, хотя она ускоряет вылет из индекса |
| 503 | Плановые работы | Вместо неё показывают заглушку с кодом 200 |
Порядок проверки архитектуры своего сайта
Аудит каркаса укладывается в один рабочий день, если идти по порядку и не отвлекаться на тексты. Последовательность такая.
- Обход краулером от главной. Получаете список достижимых страниц, глубину, коды ответа, дубли title. Уже на этом шаге видно, сколько страниц робот вообще способен найти.
- Сверка с картой сайта и с отчётом Вебмастера. Три списка — краулер, sitemap, страницы в поиске — почти никогда не совпадают. Разница между ними и есть список задач.
- Проверка зеркал и кодов. Четыре варианта хоста, слеш, регистр, несуществующий адрес, страница с параметром.
- Разбор шаблонов. По одному образцу каждого типа: заголовки, канониклы, мета-теги, наличие текста в исходном коде.
- Логи сервера за две-четыре недели. Показывают, куда робот ходит на самом деле. Регулярно выясняется, что половина обходов уходит на страницы фильтров и поиска по сайту.
- Скорость и отдача статики. Замер на мобильном соединении, проверка заголовков кэширования и сжатия.
Из инструментов достаточно связки: десктопный краулер, Яндекс Вебмастер, Google Search Console, доступ к логам через панель хостинга. Для оценки спроса и конкурентов пригодятся Вордстат, Мегаиндекс, Rush Analytics или Topvisor — но это уже следующий этап, к каркасу он отношения не имеет.
Ошибки архитектуры, которые дороже всего исправлять
Список составлен по повторяемости: это то, что встречается в работе чаще всего и требует программиста, а не контент-менеджера.
- Фильтры без правил индексации. Комбинации параметров дают десятки тысяч почти одинаковых адресов. Решение — открывать в индекс только заранее выбранные посадочные комбинации, остальное закрывать канониклом и мета-тегом.
- Один шаблон title на весь тип страниц. «Купить товар — Название магазина» на пяти тысячах карточек означает пять тысяч почти одинаковых заголовков. Формулу надо строить из полей: название, характеристика, бренд, город.
- Смена CMS без карты редиректов. Новый движок ставит новые адреса, старые отдают 404, и накопленные позиции обнуляются. Карта соответствия готовится до переезда, а не после.
- Дублирующий доступ к контенту. Товар доступен и по адресу категории, и по прямому короткому адресу, и через тег. Нужен один канонический путь.
- Мобильная версия на отдельном поддомене. Наследие прошлого десятилетия, которое до сих пор встречается: два сайта с одинаковым содержимым, рассинхронизированные по контенту. Правильное решение — адаптивная вёрстка на одном адресе.
- Бесконечные календари и архивы. Блочный календарь с переходом на предыдущий месяц генерирует бесконечную цепочку пустых страниц. Робот ходит по ней месяцами.
Частые вопросы
Обязательно ли держать все страницы в двух кликах от главной? Нет, это невозможно на любом каталоге крупнее сотни позиций. Задача не в том, чтобы всё было близко, а в том, чтобы близко было то, что приносит деньги, и чтобы у остальных страниц глубина не уходила за пятый уровень без нужды.
Влияют ли ключевые слова в адресе страницы на позиции? Эффект есть, но он слабый и давно перестал быть решающим. Осмысленный адрес полезнее для людей и для внешних ссылок: его читают в переписке, по нему понятно, куда ведёт ссылка. Ради ключа в URL переименовывать существующие страницы точно не стоит.
Что делать с хвостом пагинации на большом каталоге? Три варианта, в порядке предпочтения: сократить число страниц пагинации увеличением количества товаров на страницу, добавить блоки ссылок на популярные подборки, чтобы сократить путь, и только в крайнем случае закрывать глубокие страницы от индексации. Полное закрытие пагинации лишает робота пути к товарам.
Нужен ли отдельный сайт под каждый город? Обычно нет. Поддомены и отдельные домены под города требуют раздельного наполнения и раздельного продвижения, иначе получается сеть почти одинаковых сайтов. Начинать надо с региональных страниц внутри одного сайта и настройки региона в Вебмастере.
Как понять, что архитектура мешает именно сейчас? Признаков три: число страниц в поиске заметно меньше числа реальных страниц, обновления доезжают до выдачи неделями, а в логах видно, что робот ходит по адресам, которых не должно быть в природе. Любого из трёх достаточно, чтобы начать с каркаса, а не с текстов.
Коротко
- Архитектура — это каркас: вложенность, адреса, шаблоны, коды ответа, файлы на сервере. Структуру разделов разбирают отдельно и другими методами.
- Для обхода важна кликовая глубина, а не число сегментов в URL: считайте переходы от главной, а не слеши в адресе.
- Один документ — один адрес. Зеркала, слеш, регистр и параметры — четыре источника дублей, которые закрываются один раз и навсегда.
- Правка в шаблоне умножается на все страницы этого типа, поэтому аудит начинают с образцов шаблонов, а не с выгрузки всех URL.
- Всё значимое должно быть в html до выполнения скриптов: ссылки тегом a, цена и текст в исходном коде.
- Ошибки каркаса невидимы при обычном просмотре сайта и находятся только краулером, логами и отчётами Вебмастера.
Если по вашему сайту непонятно, что именно мешает — глубина, дубли по параметрам или шаблон, отдающий 200 на несуществующие адреса, — приходите на SEO-консультацию: посмотрим сайт, отчёты Вебмастера и логи вместе, и я назову те правки каркаса, которые в вашем случае дадут результат раньше остальных.
Увеличьте позиции и продажи вашего сайта
Профессиональное SEO-продвижение с гарантией результата. Выберите подходящую услугу:
Остались вопросы по продвижению?
Меня зовут Анатолий Кузнецов, я SEO-оптимизатор с 20-летним стажем. Разберу ваш сайт, отвечу на вопросы и подскажу, что улучшить для роста позиций в Яндексе и Google.
Связаться со мной → Старт
 Стандарт
 Премиум



Комментарии
Аким Решетов
Обошёл магазин краулером после статьи. Из одиннадцати тысяч карточек на глубине до трёх уровней оказалось четыреста, остальное на пятом и глубже — через пагинацию по сорок восемь страниц в каждой категории. Разработчик говорит, что это нормально для каталога такого размера. По вашей таблице выходит, что не нормально. Кто прав?
Анатолий Кузнецов автор
Правы вы, но разработчик тоже описывает реальность честно: при линейной пагинации на большом каталоге иначе и не выходит. Спорить надо не о норме, а о том, как сократить путь. Три шага дают эффект почти сразу. Первый — увеличить количество товаров на странице листинга, это механически режет число страниц пагинации в два-три раза. Второй — сделать в пагинации числовые блоки со скачками, чтобы до середины списка добираться за два перехода, а не за двадцать. Третий — добавить хабовые подборки: «популярное в категории», «по бренду», «по применению», и поставить на них ссылки из шапки категории. После этих правок посмотрите распределение по глубине ещё раз тем же краулером — цифры сравнимы только при одинаковой методике замера.
Марта Сорочкина
Разделение архитектуры и структуры разделов забрала в работу целиком. У нас подрядчик присылал один общий список задач, где «переименовать раздел» стояло рядом с «настроить 404», и приоритеты выставлялись случайно. Разбили на две таблицы, стало видно, что половина пунктов вообще не к разработчику.
Терентий Скоморохов
Не соглашусь про мобильную версию на поддомене. У нас m-версия живёт с 2017 года, трафик идёт, ничего не рассинхронизировано, потому что контент подтягивается из одной базы. Переделывать на адаптив — это переписывать фронтенд целиком ради непонятного выигрыша.
Анатолий Кузнецов автор
Если контент общий и разметка связи между версиями настроена корректно, гнать вас на переделку я не буду — работающую систему ломают не из принципа. Проверьте только четыре вещи, потому что расхождения обычно не в текстах, а в мелочах. Первое: совпадают ли title и описание между версиями, они часто генерируются разными шаблонами. Второе: есть ли на мобильной версии те же внутренние ссылки, что и на десктопной, — урезанное мобильное меню меняет кликовую глубину для мобильного робота. Третье: одинаковый ли набор страниц, обычно на m-версии не хватает служебных разделов. Четвёртое: куда ведут внешние ссылки и что отдаётся в поиске по конкретным запросам. Если по всем четырём порядок, оставляйте как есть и вкладывайтесь в другое.
Виолетта Стерхова
Проверила страницу ошибки, как советуете. Отдаёт 200 и красивую картинку с надписью «упс». Сайту четыре года, никто ни разу это не смотрел. Пошла к разработчику.
Мирон Сутормин
Вопрос про логи. Хостинг отдаёт их архивами по дням, за месяц получается несколько гигабайт. Чем это вообще открывать человеку без программиста? В панели хостинга статистика показывает только общие цифры, по каким адресам ходит робот — не видно.
Анатолий Кузнецов автор
Гигабайты открывать целиком не надо, из лога нужны две колонки: адрес и user-agent. Порядок для человека без программиста такой. Скачайте архивы за две недели, распакуйте в одну папку. Возьмите любой анализатор логов с готовыми отчётами по поисковым ботам — их несколько, в том числе бесплатные, и они принимают папку с файлами на вход. Отфильтруйте строки по агенту Яндекса и посмотрите два отчёта: топ адресов по числу заходов и распределение по кодам ответа. Дальше смотрите глазами: если в топе адреса с параметрами, страницы поиска по сайту или пагинация глубже двадцатой страницы, обход тратится не туда. И проверьте достоверность источника: часть запросов с агентом Яндекса приходит от посторонних скриптов, у настоящего робота адреса резолвятся в домены поисковика.
Ада Сухинина
У нас сайт на конструкторе, доступа к серверу и логам нет вообще. Из вашего списка проверок реально доступны только краулер и Вебмастер. Получается, половина аудита для таких сайтов недоступна по определению.
Лаврентий Рупасов
Про 410 добавлю из опыта. Закрывали направление, сносили около двух тысяч карточек. Сначала отдавали 404 — робот перепроверял их полгода, обход тратился впустую. Поставили 410, за пару месяцев он снял их с проверки. Для единичных страниц разницы не заметил, а вот на массовом удалении она есть.
Клара Рындина
Про календарь в блоге — прямо в точку. У нас виджет архива генерировал переходы на любой месяц вплоть до 1970 года, и в поиске висело около шестисот пустых страниц. Убрали виджет, поставили 410, за полтора месяца всё вычистилось.
Севастьян Рогалёв
Не хватило конкретики по фильтрам. Написано «открывать только выбранные комбинации», но по какому критерию выбирать? У нас в категории шин семь параметров, комбинаций сотни тысяч, и понять, какие из них нужны людям, на глаз невозможно.
Анатолий Кузнецов автор
На глаз и не надо, критерий тут внешний. Комбинация фильтров заслуживает отдельной страницы, если по ней есть сформулированный спрос и есть товары в наличии. Порядок работы такой. Соберите частотность по шаблонам запросов из Вордстата: «шины 205 55 r16», «шины зимние шипованные r16» и так далее — то есть по тем сочетаниям параметров, которые люди реально набирают. Обычно живых комбинаций оказывается не сотни тысяч, а сто-двести на категорию, и почти все они из двух-трёх параметров, а не из семи. Дальше отсеките те, где у вас меньше десятка товаров: пустой листинг в поиске работает против вас. Оставшееся открывайте, готовьте им свой title и краткое описание, ставьте ссылки на них из тела категории. Всё, что не вошло, — канонический адрес на категорию и мета-тег noindex.
Афанасий Стукалов
Добавлю про переезд с CMS. Мы делали карту редиректов правилом с подстановкой, как раз как в статье не рекомендуется. Из шести тысяч адресов правило корректно отработало на пяти с половиной, а остальные ушли в цепочки по три перехода. Разбирали потом руками два месяца.
Рафаил Скрипачёв
Проверил исходный код, как написано. Меню у нас собирается скриптом, ссылок в html нет ни одной — только элементы с обработчиками. При этом страницы в индексе есть, они попадают туда из карты сайта. Значит, робот их видит, но вес по ним не течёт вообще?
Анатолий Кузнецов автор
Примерно так и есть, только формулировка чуть мягче. Карта сайта сообщает адреса, поэтому страницы индексируются, но она не передаёт ни веса, ни контекста: робот не знает, какая страница главнее, из какого раздела она и каким текстом на неё ссылаются. Внутренняя перелинковка у вас фактически отсутствует, и это заметно по тому, как ведут себя такие сайты — все страницы примерно равны по значимости, вытянуть конкретную посадочную нечем. Правка недорогая: попросите разработчика отдавать меню обычными тегами a с href, а скрипты навесить поверх для анимации. Внешний вид не изменится, а в исходном коде появятся настоящие ссылки. После правки обойдите сайт краулером ещё раз — до неё он тоже не найдёт ничего, кроме главной.
Юния Свищёва
Вопрос по sitemap. У нас карта генерируется плагином, и дата изменения проставляется по дате генерации файла, то есть у всех страниц одинаковая и меняется каждую ночь. Судя по статье, это плохо. Но плагин других вариантов не предлагает, а без карты, кажется, ещё хуже?