




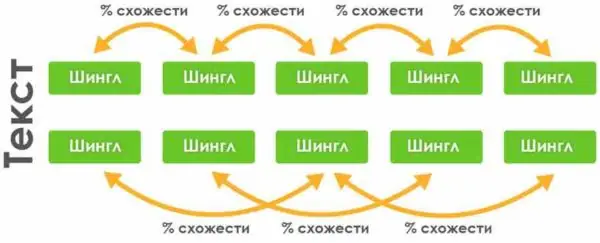

Шингл текста стоит за каждым процентом уникальности, который выдаёт антиплагиат, и почти никогда не объясняется теми, кто эти проценты требует. Заказчик просит «не меньше 95 по Advego», копирайтер крутит слова местами до нужной цифры, а на выходе получается текст, который прошёл проверку и провалился в поиске. Чтобы такого не случалось, полезно понимать, что именно считает антиплагиат и почему его результат не имеет прямого отношения к тому, как оценит страницу поисковая система.
Я в SEO с 2005 года, и за это время через мои руки прошли тысячи текстов — от карточек товара до многостраничных обзоров. Ниже — техническая механика шинглирования без упрощений: как текст режется на фрагменты, откуда берутся расхождения между сервисами, для чего этот же метод применяют Яндекс и Google, и что на самом деле нужно делать, чтобы материал не считался копией.
Что скрывается за словом «шингл»
Слово пришло из английского shingle — черепица, дранка. Смысл в способе укладки: фрагменты накладываются друг на друга внахлёст. Алгоритм не сравнивает документы целиком, он режет каждый текст на короткие цепочки подряд идущих слов и сопоставляет уже наборы этих цепочек.
Возьмём фразу «не так сложно без труда написать оригинальную статью». Перед нарезкой она проходит канонизацию: убираются знаки препинания и служебные слова, регистр приводится к нижнему, слова ставятся в начальную форму. Останется примерно так: сложно труд написать оригинальный статья. Дальше последовательность режется на цепочки заданной длины со сдвигом в одно слово.
- Позиция 1: сложно труд написать
- Позиция 2: труд написать оригинальный
- Позиция 3: написать оригинальный статья
Из короткого предложения получилось три шингла. В статье на десять тысяч знаков их будет несколько тысяч. Каждая цепочка превращается в число — контрольную сумму, — и дальше машина сравнивает не строки, а массивы чисел. Это быстро и дёшево: именно поэтому метод пережил три десятилетия и до сих пор лежит в основе всех сервисов проверки.
Важная деталь, которая объясняет половину странностей антиплагиата: сравнение идёт по совпадению цепочек, а не по смыслу. Два текста об одном и том же, написанные разными людьми, дадут почти нулевое пересечение. И наоборот — механически переставленные абзацы чужого текста сохранят большинство исходных шинглов, потому что внутри предложений порядок слов не изменился.
Как устроен алгоритм проверки по шагам
Классическая процедура состоит из пяти этапов, и понимание каждого снимает большинство вопросов к результатам сервисов.
- Канонизация. Текст очищается от пунктуации, приводится к нижнему регистру, из него удаляются стоп-слова — предлоги, союзы, частицы. Слова приводятся к нормальной форме через лемматизацию или обрубаются до основы стеммингом. Наборы стоп-слов у сервисов разные, и это первый источник расхождений.
- Нарезка на шинглы. Очищенная последовательность режется на пересекающиеся цепочки фиксированной длины. Длина — главная настройка строгости.
- Хеширование. Каждая цепочка переводится в контрольную сумму. Сравнивать числа быстрее, чем строки, и результат не зависит от длины исходного фрагмента.
- Отбор выборки. Хранить все хеши документа дорого, поэтому берётся часть — например, каждый хеш, делящийся на определённое число, или несколько минимальных значений. Так формируется компактный отпечаток документа.
- Сравнение. Считается доля совпавших хешей между вашим текстом и документами базы. Отсюда и получается процент заимствования или, наоборот, уникальности.
Четвёртый шаг объясняет, почему один и тот же текст при повторной проверке иногда даёт слегка отличающийся результат: выборка вероятностная, а база пополняется. Пятый объясняет главное ограничение метода — сравнение идёт не «со всем интернетом», а с конкретной базой конкретного сервиса.
Длина шингла и почему цифры пляшут
Чем короче цепочка, тем придирчивее проверка. Шингл из двух слов совпадёт даже в разных по смыслу текстах, потому что устойчивые обороты вроде «в первую очередь» или «по данным исследования» встречаются везде. Шингл из восьми слов требует почти дословного повторения целого предложения.
Подробнее об этом — в статье «Оптимизация текста под поисковый запрос».
| Длина шингла | Строгость | Что ловит | Побочный эффект |
|---|---|---|---|
| 2–3 слова | Очень высокая | Рерайт, перестановки, устойчивые обороты | Много ложных срабатываний на общей лексике |
| 4–5 слов | Сбалансированная | Заимствования и глубокий рерайт | Оптимальный компромисс для большинства задач |
| 6–8 слов | Мягкая | Прямой копипаст предложений | Пропускает переписанный своими словами текст |
Отсюда прямое следствие: один материал в разных сервисах покажет разную уникальность, и расхождение в 10–30 процентных пунктов — норма, а не сбой. У сервисов различаются длина шингла, набор стоп-слов, правила канонизации, размер выборки хешей и, главное, содержимое базы. Спорить, чья цифра «правильная», бессмысленно: у них разные определения того, что считать совпадением.
Практический вывод для тех, кто принимает работу: требование конкретного процента имеет смысл только вместе с указанием сервиса и его настроек. «95% уникальности» без уточнения инструмента — не техническое требование, а пожелание.
Почему база важнее алгоритма
Помогу с продвижением: продвижение сайта в поиске — вывожу сайты в топ Яндекса белыми методами.
Сервис сравнивает ваш текст с тем, что у него есть. Если исходник не попал в базу — статья из закрытого раздела, документ в PDF, публикация в соцсети, — антиплагиат покажет высокую уникальность у откровенной копии. Обратная ситуация встречается чаще: свежий авторский текст проверяют через неделю после публикации, и он уже собрал заимствования, потому что успел разойтись по агрегаторам и парсерам.
Отсюда несколько практических правил, которые я применяю при приёмке материалов.
- Проверять до публикации, а не после. После выхода статьи любой сервис начнёт находить копии на сайтах-клонах, и разобрать, кто первоисточник, будет сложнее.
- Смотреть не процент, а подсветку. Все нормальные сервисы показывают, какие именно фрагменты сочтены заимствованными и с каких адресов. Если подсвечены термины, названия законов и цитаты — это нормально. Если подсвечены целые абзацы с одного сайта — это копипаст.
- Игнорировать совпадения на технической лексике. Названия тегов, формулировки директив, юридические конструкции повторить иначе невозможно, и понижать за них процент бессмысленно.
- Сохранять отчёт с датой. Это единственное доказательство первичности, если позже придётся разбираться с копированием.
Как шинглирование используют поисковые системы
Яндекс и Google применяют тот же математический аппарат, но для другой задачи. Их не интересует «процент уникальности» — им нужно решить две прикладные проблемы.
Дедупликация индекса. Когда по сети расходятся десятки копий одной публикации, хранить их все бессмысленно. По совпадению отпечатков система определяет кластер дублей и оставляет в выдаче одну версию. Остальные уходят в разряд малоценных и в поиске не показываются.
Выбор канонического документа. Внутри кластера выбирается главный. Критерии выбора шире, чем дата: учитываются авторитетность домена, момент первого обнаружения, внутренние и внешние ссылки, поведение пользователей. Именно поэтому копия на крупном портале иногда обходит оригинал на молодом сайте — не потому что «украли и победили», а потому что система сочла её более надёжным источником.
Есть и третье применение, о котором вспоминают реже: поиск почти-дублей внутри одного сайта. Карточки товара, отличающиеся одним словом в названии, страницы фильтров с одинаковым текстом, региональные копии услуг — всё это склеивается тем же механизмом, и часть страниц выпадает из индекса с пометкой о недостаточном качестве. Проблема решается не переписыванием ради процентов, а добавлением того, что действительно различается: характеристик, условий, цен, примеров.
Тему разбирал отдельно: «Как влияет уникальность текста на позиции сайта».
Почему «100% уникальности» не равно качеству
Самая дорогая иллюзия в работе с текстами. Уникальность по шинглам — это отсутствие совпадающих цепочек слов. Ни одно из свойств, за которые страница получает позиции, этим показателем не измеряется.
Текст может быть уникален на сто процентов и при этом:
- не отвечать на запрос, по которому его продвигают, — тогда посетитель уходит за ответом дальше, и это фиксируется поведенческими факторами;
- содержать фактические ошибки — уникальная неправда остаётся неправдой;
- быть синонимизированным до нечитаемости: замена слов на редкие синонимы поднимает процент и убивает смысл;
- пересказывать статью конкурента другими словами, не добавляя ничего нового, — формально уникально, содержательно вторично;
- дублировать по смыслу другую страницу вашего же сайта, конкурируя с ней в выдаче.
Обратное тоже верно: страница с невысоким формальным процентом бывает совершенно нормальной. Инструкция, которая цитирует текст закона, обзор, приводящий характеристики производителя, рецепт со стандартным списком ингредиентов — везде есть неизбежные совпадения, и они ничему не мешают.
Отдельная тема — тексты, сгенерированные нейросетевыми сервисами. По шинглам они почти всегда уникальны: модель не копирует фразы, она собирает новые. Но уникальность здесь не означает ценности — сгенерированный без правки материал обычно пересказывает общеизвестное, не содержит проверяемых деталей и легко распознаётся по ровной безличной интонации. Проверка на шинглы такой текст пропустит, а поисковая система оценит его по другим признакам.
Что делать, если текст скопировали
Если нужна помощь по теме — тексты для сайта.
Ситуация обычная, и паниковать в ней не нужно. Порядок действий такой.
- Убедиться, что оригинал ваш. Найти дату первой публикации, сохранённую копию, отчёт проверки. Без этого разговор не начинается.
- Проверить, кто в выдаче. Возьмите характерное предложение из статьи в кавычках и посмотрите, чья версия показывается первой. Если ваша — делать ничего не нужно, система уже разобралась.
- Написать владельцу площадки. Как ни странно, срабатывает чаще всего: значительная часть копий делается автоматически, и на прямое обращение просто удаляют страницу.
- Обратиться к хостеру или в форму обратной связи поисковой системы. Работает медленнее, но действует, когда владелец не отвечает.
- Усилить оригинал. Дополнить статью, обновить дату изменения, поставить на неё внутренние ссылки. Чем сильнее сигналы у вашей версии, тем увереннее она остаётся канонической.
Профилактика надёжнее борьбы: публиковать материал сразу на своём домене, а не сначала в чужом блоге, и отправлять новые страницы на переобход в тот же день. Чем раньше система увидела текст у вас, тем прочнее ваша позиция в кластере дублей.
Смежный материал по теме — «Тошнота текста».
Как писать текст, который проходит и проверку, и поиск
Единственный надёжный способ получить высокую уникальность — писать самому, опираясь на то, чего нет у конкурентов. Ниже — приёмы, которые дают результат по обоим критериям сразу.
- Начинать со структуры, а не с чужого текста. Соберите вопросы, которые задаёт клиент, и стройте разделы под них. Тогда совпадать будет нечему: у вас другая логика изложения.
- Добавлять то, что можно проверить. Порядок действий, критерии выбора, условия, при которых способ не работает, ограничения. Такие фрагменты невозможно взять из чужой статьи, потому что там их нет.
- Не синонимизировать. Замена слов ради процентов ухудшает читаемость и распознаётся как искусственная обработка. Проще переписать абзац заново своими словами.
- Сокращать общие места. Вступления вида «в современном мире» и «ни для кого не секрет» дают совпадения и не несут информации. Их удаление одновременно поднимает уникальность и улучшает текст.
- Проверять пересечение со своими же страницами. Перед публикацией стоит убедиться, что новый материал не повторяет то, что уже есть на сайте, иначе страницы начнут конкурировать между собой.
- Оценивать полноту ответа, а не длину. Объём набирается разделами, закрывающими реальные вопросы, а не растягиванием одной мысли на три абзаца.
Частые вопросы
Какой процент уникальности считать нормой?
Для информационной статьи — от 85–90 по среднему сервису при условии, что подсвеченные фрагменты являются терминами, цитатами и устойчивыми оборотами. Для карточки товара с характеристиками производителя нормой бывает и 60: характеристики нельзя переписать, не исказив. Смотреть надо на состав совпадений, а не на число.
Почему один текст в двух сервисах даёт 96 и 78?
Потому что у них разная длина шингла, разные списки стоп-слов и разные базы. Сервис с шинглом в три слова найдёт совпадения там, где сервис с шинглом в пять их не заметит. Выберите один инструмент и сравнивайте материалы между собой в нём, а не цифры из разных систем.
Влияет ли уникальность на позиции напрямую?
Напрямую — нет, такого множителя не существует. Влияет попадание в кластер дублей: если ваша страница признана копией, она не показывается в выдаче вовсе. Это влияние не постепенное, а бинарное, и именно поэтому копипаст опасен, а неидеальный процент — нет.
Можно ли повысить уникальность, не переписывая текст?
Технически да — заменой слов на синонимы и перестановкой конструкций. Практически это ухудшает материал: он становится тяжелее для чтения и приобретает характерную неестественность. Дешевле дописать два новых раздела с конкретикой, чем перелопачивать существующие.
Как проверить, не дублирует ли новая статья старую на моём же сайте?
Возьмите два-три характерных предложения из черновика и поищите их в кавычках с ограничением по своему домену. Дополнительно сравните, под какие запросы обе страницы написаны: если формулировки совпадают, материалы нужно объединять, а не публиковать рядом.
Стоит ли требовать 100% от копирайтера?
Нет. Такое требование заставляет исполнителя синонимизировать текст ради цифры, и вы получаете формально чистый, но нечитаемый материал. Разумнее задать порог с запасом и отдельно проверять фактическую точность и полноту ответа на запрос.
Показываю, как выглядит разбор текстов на сайте и что в них обычно приходится править:
Коротко
- Шингл — цепочка из нескольких подряд идущих слов; проверка на уникальность сравнивает не тексты, а наборы хешей от таких цепочек.
- Расхождение результатов между сервисами нормально: у них разная длина шингла, разные стоп-слова и, главное, разные базы для сравнения.
- Требование «95% уникальности» без указания сервиса и настроек не является техническим требованием.
- Поисковые системы применяют шинглирование не для оценки качества, а для склейки дублей и выбора канонической версии документа.
- Сто процентов уникальности не защищают ни от фактических ошибок, ни от вторичности, ни от конкуренции с собственными страницами сайта.
- Надёжный способ получить и высокий процент, и позиции — писать под вопросы клиента и добавлять проверяемую конкретику, которой нет у конкурентов.
Если нужно понять, почему конкретные страницы не показываются в выдаче — из-за дублей, слабого содержания или технических причин, — это SEO-консультация: смотрю проект, показываю, какие страницы склеены и почему, и говорю, что переписывать в первую очередь, а что трогать не нужно.
Увеличьте позиции и продажи вашего сайта
Профессиональное SEO-продвижение с гарантией результата. Выберите подходящую услугу:
Остались вопросы по продвижению?
Меня зовут Анатолий Кузнецов, я SEO-оптимизатор с 20-летним стажем. Разберу ваш сайт, отвечу на вопросы и подскажу, что улучшить для роста позиций в Яндексе и Google.
Связаться со мной → Старт
 Стандарт
 Премиум



Комментарии
Егор Ожиганов
Заказчик требует 100% по text.ru, иначе не принимает. Тексты технические, про станки, там половина — названия узлов и характеристики. Как это вообще возможно физически?
Анатолий Кузнецов автор
Физически невозможно, и это стоит показать заказчику на его же материале. Прогоните текст, откройте отчёт и покажите подсвеченные фрагменты: там будут названия узлов, единицы измерения и стандартные формулировки из паспорта оборудования. Спросите, какими словами он предлагает переписать «редуктор цилиндрический двухступенчатый», чтобы смысл не поменялся. Обычно этого хватает. Рабочий компромисс, который я предлагаю в таких случаях, — фиксировать не процент, а состав совпадений: допускаются термины, характеристики и цитаты, не допускаются связные абзацы с чужих сайтов. Требование становится проверяемым, а текст остаётся читаемым.
Алла Осечкина
Проверила свою статью через месяц после публикации — уникальность упала с 97 до 61. Никому её не отдавала. Получается, украли?
Анатолий Кузнецов автор
Скорее всего, её растащили автоматические парсеры — это происходит с любым материалом, который попал в индекс. Проверьте по отчёту, с каких адресов идут совпадения: если это агрегаторы и сайты-клоны с копией целиком, ситуация типовая. Дальше смотрите не на процент, а на выдачу: возьмите характерное предложение из статьи в кавычках и посмотрите, чья версия показывается первой. Если ваша — система уже определила первоисточник, и делать ничего не нужно. Если чужая, стоит написать владельцу площадки и одновременно усилить свою версию: дополнить материал, поставить на него внутренние ссылки, отправить на переобход. Падение процента само по себе ни на что не влияет.
Тимофей Пермяков
А как поисковик выбирает первоисточник, если обе публикации в один день? У нас была история, когда копия на большом портале обошла наш оригинал.
Анатолий Кузнецов автор
Дата — только один из признаков, и далеко не главный. Внутри кластера дублей учитываются авторитетность домена, скорость, с которой робот увидел документ, ссылки на страницу, поведение посетителей. Крупный портал обходит новый сайт не из-за несправедливости алгоритма, а потому что по всем этим сигналам он выглядит надёжнее. Практический вывод простой: публиковать сначала у себя, а не в чужом блоге с обещанием «а потом заберёте», и отправлять страницу на переобход в день публикации. Если материал уже проиграл кластер, помогает расширение оригинала — добавьте разделы, которых нет в копии, и версии перестанут быть идентичными.
Регина Пискарёва
Не поняла про выборку хешей. Зачем брать часть, если можно сравнить все? Это же теряет точность.
Анатолий Кузнецов автор
Теряет, но потеря контролируемая, а выигрыш огромный. У статьи в десять тысяч знаков несколько тысяч шинглов, и хранить их все для каждого документа базы — это объёмы, при которых сравнение перестаёт быть мгновенным. Выборка сокращает отпечаток в десятки раз, а вероятность пропустить существенное совпадение остаётся низкой: если тексты действительно пересекаются, они пересекаются на сотнях цепочек, и отобранные хеши это поймают. Побочный эффект вы наверняка замечали: повторная проверка того же текста иногда даёт немного другой процент. Это не сбой, а следствие вероятностной природы метода и пополнения базы между проверками.
Денис Оверченко
У нас интернет-магазин, 3000 карточек, описания похожи между собой — товары одной линейки. Часть выпала из индекса как малоценные. Это тот самый механизм склейки?
Анатолий Кузнецов автор
Он самый, только применённый внутри одного сайта. Карточки одной линейки отличаются парой слов, отпечатки почти совпадают, система оставляет одну и помечает остальные. Переписывание описаний ради процентов здесь не поможет: синонимы не создают различий, ради которых страницу стоит держать в индексе. Работает другое — добавить в карточку то, что реально отличает товар: полную таблицу характеристик с конкретными значениями, условия применения, комплектацию, отзывы. Второй приём для больших каталогов: не пытаться вытащить все три тысячи, а выбрать позиции с реальным спросом по Вордстату и проработать сначала их. Остальные пусть живут через категорию.
Милана Олькова
Спасибо за таблицу с длиной шингла. Всегда думала, что разница в сервисах — это их косяки, а оказывается, они просто по-разному настроены.
Борис Питиримов
А почему стоп-слова вообще выкидывают? Мне кажется, из-за этого и ловятся ложные совпадения — текст обедняется до набора корней.
Оксана Пепеляева
Работаю редактором, приняла на вооружение мысль про подсветку вместо процента. Раньше отправляла на доработку по цифре, теперь смотрю, что именно совпало. Половина возвратов оказалась лишней.
Артур Осадчиков
Есть вопрос по нейросетевым текстам. Если они уникальны по шинглам и написаны нормально, поисковик их вообще как-то отличает? Или всё дело только в содержании?
Инна Перескокова
Проверила две свои статьи на пересечение между собой, как советуете. Оказалось, они на 40% про одно и то же и обе висят на второй странице. Похоже, надо объединять.
Матвей Онисимов
Не соглашусь про синонимизацию как абсолютное зло. Иногда замена канцелярита на нормальные слова и текст улучшает, и процент поднимает. Вопрос в том, кто и зачем это делает.
Дарья Пыхтина
Подскажите, а сохранённый отчёт проверки с датой реально помогает в спорах? Или это только для собственного спокойствия?