




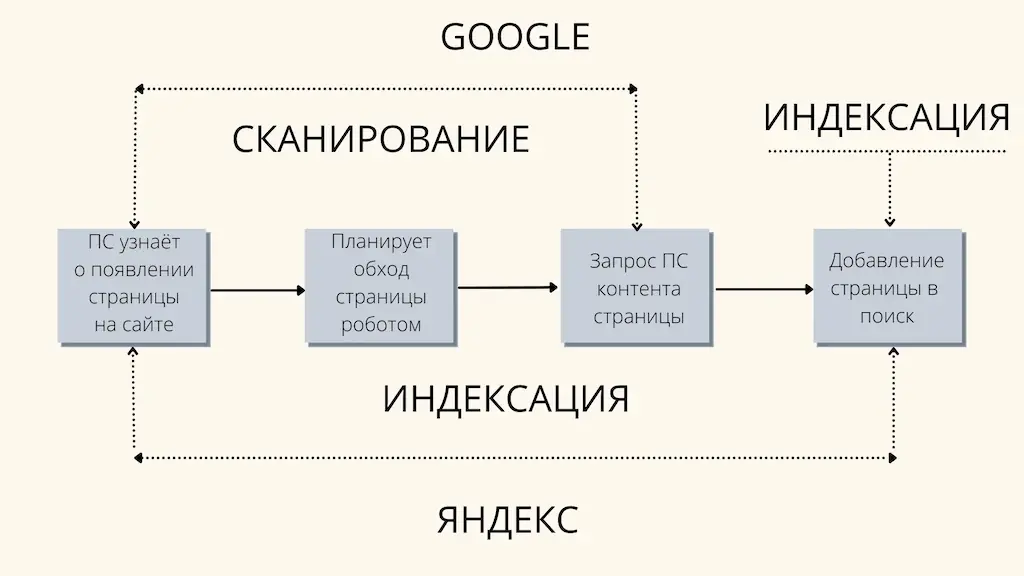

Факторы, влияющие на индексацию сайта, удобнее держать в голове не списком из пятнадцати пунктов, а тремя воротами, через которые страница проходит по очереди. Сначала робот должен о ней узнать. Потом — суметь её загрузить. И только потом поиск решает, стоит ли держать этот документ в базе и показывать людям. Половина споров об индексации возникает из-за того, что эти три этапа смешивают в один: страница не в поиске, значит «плохой контент», хотя робот до неё вообще не доходил, потому что на неё нет ни одной внутренней ссылки.
В SEO я с 2005 года, и материал ниже — справочник, а не инструкция. Что именно влияет на попадание страницы в индекс, что мешает, как каждый фактор проверить своими руками за пять минут и по каким признакам отличить проблему обхода от проблемы отбора. Отдельные разборы того, как ускорить индексацию и как устроен краулинговый бюджет, в блоге уже есть — здесь задача другая: разложить факторы по группам, чтобы вы понимали, где искать причину, прежде чем что-то чинить.
Три этапа, которые нельзя путать
Обнаружение. Робот узнаёт адрес страницы из внутренних ссылок, из карты сайта, из внешних ссылок, из ранее известных адресов и из данных браузера. Если адрес нигде не встречается, страница не существует для поиска, каким бы хорошим ни был текст на ней.
Обход и загрузка. Робот обращается к адресу и получает ответ. Здесь решает техника: разрешён ли доступ, какой код вернул сервер, за сколько времени отдалась страница, отрисовывается ли содержимое без выполнения скриптов, не увёл ли редирект в другое место.
Отбор в индекс. Загруженный документ проходит фильтрацию: не дубль ли он, есть ли в нём самостоятельная ценность, не запрещён ли к показу мета-тегом, не назначен ли канонической другая страница. На этом этапе отсеивается больше всего страниц на средних сайтах, и именно этот этап владельцы почти не проверяют.
| Этап | Что решается | Где смотреть | Типичный симптом сбоя |
|---|---|---|---|
| Обнаружение | Знает ли поиск адрес | Логи сервера, отчёт по обходу | Страницы нет ни в одном отчёте вообще |
| Обход | Смог ли робот загрузить | Коды ответа, robots.txt, скорость | Адрес известен, статус «не удалось загрузить» |
| Отбор | Стоит ли держать в базе | Статусы страниц в Вебмастере | Загружена, но помечена как дубль или недостаточно качественная |
Практический смысл разделения простой. Если страница нигде не значится — работайте со ссылками и картой сайта. Если значится со статусом ошибки загрузки — работайте с сервером и служебными файлами. Если загружена и отклонена — работайте с содержимым и дублями. Три разные задачи, три разных набора действий, и никакой универсальной таблетки между ними нет.
Технические факторы: доступ роботу
Первая группа факторов — то, чем вы сами разрешаете или запрещаете поиску работать со страницей. Здесь чаще всего и находится причина, потому что запреты ставят один раз при разработке и забывают о них навсегда.
- robots.txt. Директива Disallow закрывает обход. Робот не станет загружать адрес и не увидит, что там внутри. Классическая авария — сайт переехал с тестового домена вместе со строкой, закрывающей весь сайт целиком.
- Мета-тег robots и заголовок X-Robots-Tag. Значение noindex запрещает показ страницы в поиске. Страница при этом обходится нормально, поэтому по логам всё выглядит здоровым — а в индексе её нет.
- Атрибут rel=»canonical». Указывает, какой адрес считать основным. Ошибка в шаблоне, при которой все страницы раздела ссылаются как на канонический на главную, выкидывает из поиска весь раздел.
- Авторизация и ограничение по IP. Разделы под паролем или закрытые для всех, кроме офиса, для робота недоступны — он получает 401 или 403.
- Блокировка робота на уровне защиты. Средства защиты от ботов и капчи иногда режут поисковых роботов вместе с парсерами. Проверяется сравнением ответа для обычного браузера и для агента поискового робота.
Отдельно стоит запомнить, что запрет обхода и запрет показа — разные инструменты с разным результатом. Если страница закрыта в robots.txt, робот не может прочитать её мета-теги, поэтому noindex внутри такой страницы не сработает: чтобы увидеть запрет, нужно сначала загрузить документ.
| Инструмент | Что делает | Обход | Показ в поиске | Когда уместен |
|---|---|---|---|---|
| Disallow в robots.txt | Запрещает обращение к адресу | Нет | Как правило нет, но адрес может остаться известен | Служебные разделы, бесконечные фильтры, поиск по сайту |
| meta robots noindex | Запрещает показ документа | Да | Нет | Страницы, которые нужны людям, но не нужны в выдаче |
| rel=»canonical» | Указывает основной адрес группы | Да | Показывается канонический | Сортировки, метки, пагинация с одинаковым содержимым |
| Редирект 301 | Переносит адрес и его вес | Да | Показывается цель редиректа | Переезды, склейка дублей, смена структуры |
| Код 410 | Сообщает, что документа больше нет | Да | Нет | Удалённые товары и страницы без замены |
Технические факторы: ответ сервера и рендеринг
Вторая техническая группа — то, как сервер разговаривает с роботом. Страница может быть открыта для обхода и всё равно не попадать в базу, если ответ приходит неправильный или слишком поздно.
Код ответа. В индекс попадает только то, что отдаётся с кодом 200. Проблема встречается в двух видах: страница отдаёт 404 или 500 при живом содержимом, и обратный случай — несуществующий адрес отдаёт 200 с текстом «ничего не найдено». Второй вариант плодит бессмысленные документы, которые расходуют обход и попадают в отчёты как дубли.
Тему разбирал отдельно: «SEO факторы влияющие на продвижение сайта».
Время ответа. Медленный сервер снижает частоту обращений робота: чем дольше отдаётся документ, тем меньше страниц робот успевает взять за сеанс. На сайтах до сотни страниц это почти незаметно, на каталогах в десятки тысяч адресов — определяющий фактор.
Помогу с продвижением: продвижение сайтов белыми методами — вывожу сайты в топ Яндекса белыми методами.
Стабильность. Периодические пятисотые ошибки и таймауты робот воспринимает как сигнал снизить нагрузку. Час недоступности в сутки на регулярной основе бьёт по индексации сильнее, чем разовое падение на день.
Рендеринг. Если содержимое подставляется скриптами после загрузки, документ проходит дополнительный этап отрисовки, и это происходит не мгновенно. Текст и ссылки, которые есть в исходном коде ответа, робот получает сразу; то, что дорисовывается в браузере, — с задержкой и не всегда полностью. Проверка элементарная: отключите в браузере выполнение скриптов и посмотрите, остались ли на странице текст, заголовок и ссылки на другие разделы.
Разбор живого сайта: что именно мешает ему продвигаться:
Протокол и зеркала. Сайт должен быть доступен по одному адресу. Одновременно работающие версии с www и без, по http и https, с завершающим слешем и без — это несколько адресов с одинаковым содержимым. Поиск выберет один из них сам, и не факт, что тот, который нужен вам.
Контентные факторы: за что документ отклоняют
Самая массовая причина отсутствия страниц в поиске на сайтах, где с техникой порядок, — отбор на третьем этапе. Робот загрузил документ, сравнил его с тем, что уже есть в базе, и решил, что отдельного места он не заслуживает.
Смежный материал по теме — «Поведенческие факторы ранжирования сайта».
- Дубли внутри сайта. Один товар доступен по нескольким адресам из разных категорий, у карточек совпадают описания, у городов в мультирегиональном сайте отличается только название в заголовке. Поиск склеивает такие документы и оставляет один.
- Скопированный текст. Описания от поставщика, перепечатки новостей, справочные тексты из открытых источников. Документ уже есть в базе на других адресах, и ваша копия ничего не добавляет.
- Пустые и почти пустые страницы. Категории без товаров, теги с одной записью, разделы-заглушки, страницы результатов фильтрации, где не нашлось ничего.
- Отсутствие самостоятельной ценности. Страница есть, содержимое своё, но оно не отвечает ни на один запрос: набор общих фраз, дублирующий соседний раздел по смыслу.
- Служебные и технические адреса. Корзина, сравнение, личный кабинет, печатные версии, результаты внутреннего поиска. Их отсутствие в индексе — норма, а не проблема; проблема, когда они в индекс попадают.
Разделять здесь стоит два случая. Страницы, которые вы хотите видеть в поиске и которых там нет, — это работа. Страницы, которых там быть не должно, — тоже работа, но обратная: закрыть, склеить, удалить. Сайт, где в базе висит вчетверо больше адресов, чем полезных страниц, тратит обход на мусор, и полезные страницы обновляются реже.
Ссылочные факторы: как страницу вообще находят
Ссылки участвуют в индексации дважды: как путь, по которому робот приходит на страницу, и как признак того, что документ значим для сайта.
Внутренние ссылки. Страница без единой ссылки изнутри сайта — сирота. Её можно подать в карту сайта, и она даже попадёт в индекс, но обновляться будет редко, потому что поиск читает структуру ссылок как разметку важности. Чем меньше кликов от главной, тем чаще обход. Правило простое: любая страница, которая должна работать в поиске, обязана быть достижима по ссылкам за три-четыре перехода.
Карта сайта. XML-карта ускоряет обнаружение, особенно на больших каталогах и для новых разделов. Но карта — не замена ссылкам, а подсказка. И она обязана быть честной: адреса с кодом 404, закрытые в robots.txt страницы и неверные даты изменения в карте обесценивают её как источник.
Внешние ссылки. Упоминание сайта на стороннем ресурсе — независимый путь обнаружения. Для нового сайта это иногда единственный способ быть найденным быстро. Прямой зависимости «больше ссылок — больше страниц в индексе» нет, но у сайта, на который никто не ссылается, обход медленнее.
Если нужна помощь по теме — создание сайтов.
Атрибуты ссылок. Значение nofollow не запрещает индексацию цели и не гарантирует, что робот по ссылке не пойдёт. Управлять индексацией через атрибуты ссылок — ненадёжный способ; для этого есть noindex и canonical.
Хостовые факторы: то, что относится ко всему сайту
Часть факторов работает не на уровне страницы, а на уровне домена, и объясняет, почему два одинаково сделанных сайта индексируются с разной скоростью.
Если нужны детали, смотрите «Текстовые факторы ранжирования сайта».
- Возраст и история домена. Домен с прошлым, в котором был спам или дорвеи, обходится осторожнее. Перед покупкой домена с историей стоит посмотреть, чем он был раньше, в веб-архиве.
- Общее качество сайта. Если большая доля страниц отклонена как малополезные, новые документы проходят отбор строже. Это не наказание, а статистика: поиск накопил представление о том, что обычно приходит с этого хоста.
- Регулярность обновления. Сайт, где содержимое действительно меняется, обходится чаще. Речь именно о содержательных изменениях, а не о переставленной дате в шаблоне.
- Хостинг и соседи по IP. Дешёвый общий хостинг иногда даёт нестабильные ответы и общий IP с сомнительными проектами. Само по себе это не приговор, но нестабильность ответа — уже фактор.
- Поддомены и региональные версии. Каждый поддомен для поиска отдельный сайт со своей индексацией. Копия основного сайта на поддомене — гарантированные дубли.
Таблица: фактор и как его проверить
Сводка для самостоятельной проверки. Порядок в таблице — от самых частых причин к более редким, поэтому идти по ней имеет смысл сверху вниз.
| Фактор | Группа | Как проверить | Признак проблемы |
|---|---|---|---|
| Запрет в robots.txt | Техника | Открыть /robots.txt и проверить адрес в анализаторе Вебмастера | Адрес попадает под Disallow |
| Мета-тег noindex | Техника | Исходный код страницы, поиск по слову noindex | Тег присутствует на нужной странице |
| Канонический адрес | Техника | Исходный код, атрибут rel=»canonical» | Указывает на другую страницу |
| Код ответа | Техника | Инструмент проверки ответа сервера, вкладка «Сеть» в браузере | Не 200 на рабочей странице или 200 на несуществующей |
| Скорость ответа | Техника | Время до первого байта в браузере, отчёт по скорости обхода | Стабильно выше секунды |
| Рендеринг без скриптов | Техника | Отключить JavaScript и перезагрузить страницу | Пропадает текст, меню или ссылки |
| Зеркала и протокол | Техника | Открыть сайт с www, без www, по http | Все версии отдают 200 без склейки |
| Дубли содержимого | Контент | Отчёт о страницах в поиске, поиск по точной фразе из текста | Несколько адресов с одинаковым текстом |
| Уникальность текста | Контент | Поиск точной фразы из середины текста в кавычках | Тот же текст на десятках чужих сайтов |
| Пустые категории | Контент | Выгрузка адресов краулером, фильтр по числу слов | Разделы почти без содержимого |
| Внутренние ссылки | Ссылки | Краулер сайта, отчёт по входящим внутренним ссылкам | Ноль входящих ссылок на страницу |
| Глубина вложенности | Ссылки | Краулер, отчёт по числу кликов от главной | Более четырёх переходов |
| Карта сайта | Ссылки | Открыть sitemap.xml, проверить выборку адресов | Битые адреса, закрытые страницы, старые даты |
| Внешние упоминания | Ссылки | Отчёт по внешним ссылкам в Вебмастере | Полное отсутствие у сайта старше полугода |
| История домена | Хост | Веб-архив, отчёт о безопасности в Вебмастере | Следы прошлого проекта другой тематики |
| Доля отклонённых страниц | Хост | Статусы страниц в отчёте по индексированию | Отклонённых больше, чем в поиске |
Чего в списке факторов нет
Часть популярных советов к попаданию в индекс отношения не имеет. Разделять полезно, потому что время, потраченное на эти пункты, не возвращается.
| Утверждение | Что на самом деле |
|---|---|
| Социальные сигналы ускоряют индексацию | Ссылка из соцсети может стать путём обнаружения адреса. Количество лайков и репостов на отбор в индекс не влияет |
| Плотность ключевых слов влияет на индексацию | Не влияет. Отбор идёт по самостоятельной ценности документа, а не по числу вхождений |
| Длинный текст индексируется лучше | Объём сам по себе не аргумент. Тысяча знаков по делу проходит отбор, а десять тысяч ни о чём — нет |
| Нужно каждый день что-то публиковать | Частота обхода растёт от реальных изменений. Публикации ради частоты дают пустые страницы, которые ухудшают общую картину по хосту |
| HTTPS — фактор индексации | Влияет косвенно: смешанный контент и ошибки сертификата ломают загрузку. Сам по себе сертификат страницу в индекс не заводит |
| Мета-тег keywords помогает роботу | Не используется поисковыми системами. Заполнять его смысла нет |
Как понять, какая группа факторов виновата
Диагностика строится по охвату проблемы. Посмотрите, какие именно страницы отсутствуют в поиске, и сравните их с теми, что там есть.
- Нет всего сайта. Смотрите robots.txt, ответ сервера, доступность домена, права на сайт в Вебмастере. Контент здесь ни при чём.
- Нет одного раздела целиком. Смотрите шаблон этого раздела: мета-теги, канонический адрес, ссылки на раздел из меню, отдельные правила в robots.txt.
- Нет части страниц внутри раздела. Сравните отсутствующие с присутствующими по объёму текста, уникальности описаний, числу входящих внутренних ссылок. Почти всегда находится общий признак.
- Страницы были и пропали. Восстановите хронологию: что менялось на сайте за месяц до пропажи, включая обновление движка и правку шаблонов.
- Новые страницы заходят медленно. Это вопрос частоты обхода: скорость ответа, размер сайта, доля мусорных адресов, положение новых страниц в структуре.
Частые вопросы
Сколько ждать, прежде чем считать, что страница не индексируется? Для сайта с регулярным обходом — одна-две недели. Для нового домена без внешних ссылок — до месяца. Если в отчёте по индексированию адрес значится со статусом ошибки или «страница дублирует другую», ждать не нужно ничего: причина уже названа.
Влияет ли движок сайта на индексацию? Не сам движок, а то, что он делает по умолчанию: плодит ли адреса с метками и сортировками, отдаёт ли содержимое в исходном коде, как формирует канонические адреса. Любую популярную систему можно настроить правильно и любую — испортить.
Нужно ли закрывать страницы пагинации? Закрывать от индексации обычно не нужно: через них робот доходит до карточек. Достаточно, чтобы у страниц пагинации были свои адреса, свои заголовки и канонический адрес указывал на саму страницу пагинации, а не на первую.
Помогает ли ручная отправка адреса на переобход? Помогает ускорить конкретную страницу и не помогает ничем, если причина в запрете или в дубле. Инструмент переобхода сообщает адрес, а не отменяет отбор.
Почему в Яндексе страница есть, а в Google нет? Системы обходят и отбирают независимо, с разной скоростью и разными критериями отбора. Проверять статус нужно в панели каждой из них отдельно, и различие в пару недель — обычное дело.
Считается ли текст в изображении содержимым страницы? Нет. Текст, набранный картинкой, для отбора не существует. То же касается содержимого, спрятанного во вложенный фрейм с другого домена.
Коротко
- Индексация распадается на три этапа: обнаружение, обход и отбор в базу; причина всегда лежит на одном из них, и лечение у каждого своё.
- Технические факторы решают, дойдёт ли робот до страницы: запреты в robots.txt и мета-тегах, канонический адрес, код и скорость ответа, отрисовка без скриптов, склейка зеркал.
- Контентные факторы решают, оставят ли документ в базе: дубли, скопированные описания, пустые категории, страницы без самостоятельной ценности.
- Ссылочные факторы задают скорость: страница без входящих внутренних ссылок обходится редко, а карта сайта только подсказывает адреса, но не заменяет структуру.
- Хостовые факторы объясняют разницу между сайтами: история домена, доля отклонённых страниц, стабильность хостинга, отдельная индексация каждого поддомена.
- Диагностику ведут по охвату: нет всего сайта, нет раздела, нет части страниц — три разных диагноза, и сравнение отсутствующих страниц с присутствующими почти всегда даёт общий признак.
Если по отчётам видно, что в поиске меньше страниц, чем должно быть, а какая из групп факторов виновата — непонятно, приходите на SEO-консультацию: посмотрим отчёты Вебмастера и структуру сайта вместе и определим, где именно рвётся цепочка.
Увеличьте позиции и продажи вашего сайта
Профессиональное SEO-продвижение с гарантией результата. Выберите подходящую услугу:
Остались вопросы по продвижению?
Меня зовут Анатолий Кузнецов, я SEO-оптимизатор с 20-летним стажем. Разберу ваш сайт, отвечу на вопросы и подскажу, что улучшить для роста позиций в Яндексе и Google.
Связаться со мной → Старт
 Стандарт
 Премиум



Комментарии
Аркадий Шелехов
Проверил по таблице свой каталог и нашёл то, о чём не догадывался: у всех карточек товара канонический адрес ведёт на категорию. Шаблон писали три года назад, никто с тех пор в код не заглядывал. Получается, весь каталог сам себя выкидывал из поиска, а мы всё это время дописывали описания.
Анатолий Кузнецов автор
Это одна из самых частых поломок в шаблонах, и находится она обычно именно так — случайно. Дальше действуйте по порядку. Сначала исправьте канонический адрес на самого себя и убедитесь, что правка попала на все типы карточек, а не только на те, что вы открывали: у товаров с вариациями и у акционных позиций часто отдельный шаблон. Потом проверьте карту сайта — велика вероятность, что карточек в ней нет, раз система считала их неканоническими. И только после этого отправляйте выборку адресов на переобход, штук по двести в день, начиная с тех разделов, где спрос выше. Полная переиндексация каталога займёт от нескольких недель до пары месяцев, это нормальный срок, досрочно паниковать не нужно.
Борис Шамрай
Спорный момент про пагинацию. Мне два разных специалиста говорили ровно противоположное: один требовал закрыть все страницы со второй, другой — оставить открытыми. Теперь понимаю, что спор был вообще не о том: важно не закрывать или открывать, а чтобы робот через них доходил до товаров.
Вадим Шергин
У меня сайт услуг на двенадцать страниц, все в индексе, но новые статьи в блоге заходят по три недели. Внешних ссылок нет вообще. По статье выходит, что дело в частоте обхода, а не в текстах. Только непонятно, что с этим делать маленькому сайту — ссылки покупать не хочу.
Анатолий Кузнецов автор
Покупать ничего не нужно, для двенадцати страниц это лишнее. Три недели на новую статью при таком размере сайта — следствие того, что робот заходит редко и ему нечего у вас забирать. Работает три вещи. Первая: ссылка на новую статью с главной или со страницы услуги, а не только из общего списка блога на третьей странице пагинации. Вторая: честная дата изменения в карте сайта — если она проставляется на все страницы разом при каждой публикации, робот перестаёт ей верить. Третья: ручная отправка адреса на переобход в день публикации, это законный и бесплатный способ сообщить о странице сразу. По моим наблюдениям на маленьких сайтах этих трёх действий хватает, чтобы срок сократился до нескольких дней.
Валерий Шкатов
Хорошо, что разделены запрет обхода и запрет показа. Я честно думал, что noindex внутри страницы, закрытой в robots.txt, работает надёжнее — мол, двойная защита. Оказывается, вторая половина этой защиты вообще не читается.
Виталий Шпагин
Пункт про рендеринг попал в цель. Сайт делали на модной библиотеке, в исходном коде пусто, всё рисуется скриптами. Разработчик уверяет, что поисковики давно всё умеют и проблемы нет. Аргументов у меня против него не было, кроме ощущения, что в поиске мало страниц.
Анатолий Кузнецов автор
Разработчик прав наполовину, и эта половина обычно и создаёт проблему. Отрисовка действительно выполняется, но не сразу и не для всех страниц одинаково: документ сначала попадает в очередь, и на большом сайте очередь может тянуться неделями. Спор переводится в проверяемую плоскость за десять минут. Возьмите инструмент проверки ответа сервера и посмотрите на исходный HTML — тот, что приходит до выполнения скриптов. Если там нет ни текста, ни заголовка, ни ссылок на другие разделы, значит робот на первом проходе получает пустую страницу. Второй шаг: сравните число страниц в поиске с числом полезных адресов сайта. Если расхождение в разы, разговор про «давно всё умеют» закрыт. Решение — серверная отрисовка или предварительная генерация HTML для роботов, обе задачи для разработчика штатные.
Владислав Шуленин
Таблица с мифами полезная. Особенно про ежедневные публикации: у нас в компании как раз стоит план по количеству статей в месяц, и качество давно принесли в жертву счётчику.
Григорий Шабашов
А как быть с мультирегиональностью? У меня двадцать три города, страницы отличаются названием города и телефоном. Половина в индексе, половина нет, и логики я не вижу — не самые крупные города выпали, а вперемешку.
Анатолий Кузнецов автор
Логика есть, просто она не про размер города. Поиск сравнивает документы между собой, и когда отличие сводится к подстановке названия и номера телефона, часть страниц отсеивается как дубли — какие именно, зависит от того, какую версию система увидела первой и на какую больше внутренних ссылок. Выход не в том, чтобы уговорить робота, а в том, чтобы страницы действительно различались: местные цены и сроки, адрес и схема проезда, названия районов и объектов, отзывы из этого города, отличающийся набор услуг, если он отличается. Если наполнить содержательно можно только пять городов из двадцати трёх, честнее оставить пять страниц, а остальные направления вести с общей страницы. Двадцать пустых копий не дадут трафика ни по одному городу, но испортят общую картину по хосту.
Даниил Шеховцов
Порядок диагностики по охвату проблемы забрал в закладки. До этого действовал наоборот: видел, что страниц мало, и сразу лез переписывать тексты. Ни разу не помогло, теперь понятно почему.
Денис Шарыгин
Про удалённые товары добавлю от себя. Магазин сезонный, каждый год уходит около четырёхсот позиций. Раньше все отдавали 404, теперь развели три случая: ушло навсегда — 410, заменено новой моделью — редирект на неё, вернётся в сезон — страница живёт с пометкой о сроках. Заодно настроили автоматическое исчезновение мёртвых адресов из карты сайта, до этого она наполовину состояла из битых ссылок.
Егор Шамшурин
Про историю домена стоило бы кричать громче. Взял красивый домен на аукционе, полгода не мог понять, почему всё идёт вязко. Заглянул в веб-архив — там раньше был файлопомоечный сайт с тысячами страниц. Проверка заняла три минуты, а сделал я её через полгода после покупки.
Ефим Шандрин
Дополню про 200 на несуществующих адресах. У нас движок на любой опечатку в адресе отдавал главную страницу с кодом 200. За год накопилось несколько тысяч таких адресов из внешних ссылок с ошибками. Нашли случайно, когда выгружали список известных страниц.
Захар Шабанов
Не соглашусь с тезисом, что внешние ссылки почти не влияют на индексацию. По моему опыту с новыми доменами разница огромная: сайт без единой ссылки заходит в базу неделями, а стоит появиться паре упоминаний на живых площадках — и обход идёт совсем иначе. Может, стоило это выделить отдельнее?
Анатолий Кузнецов автор
Ваше наблюдение и текст статьи не противоречат друг другу, речь про разные этапы. Для обнаружения нового домена внешняя ссылка действительно решает: она даёт роботу путь туда, куда он иначе не пойдёт, и на старте это самый быстрый способ. Что не работает — линейная зависимость на этапе отбора: сотня ссылок не заставит поиск оставить в базе страницу, которую он считает дублем или пустой. Поэтому для нового сайта пара живых упоминаний оправданна, а для действующего каталога с проблемами индексации закупка ссылок обычно бесполезна: причина там внутри. Если формулировать одной фразой — ссылки ускоряют обнаружение и почти не влияют на отбор.