




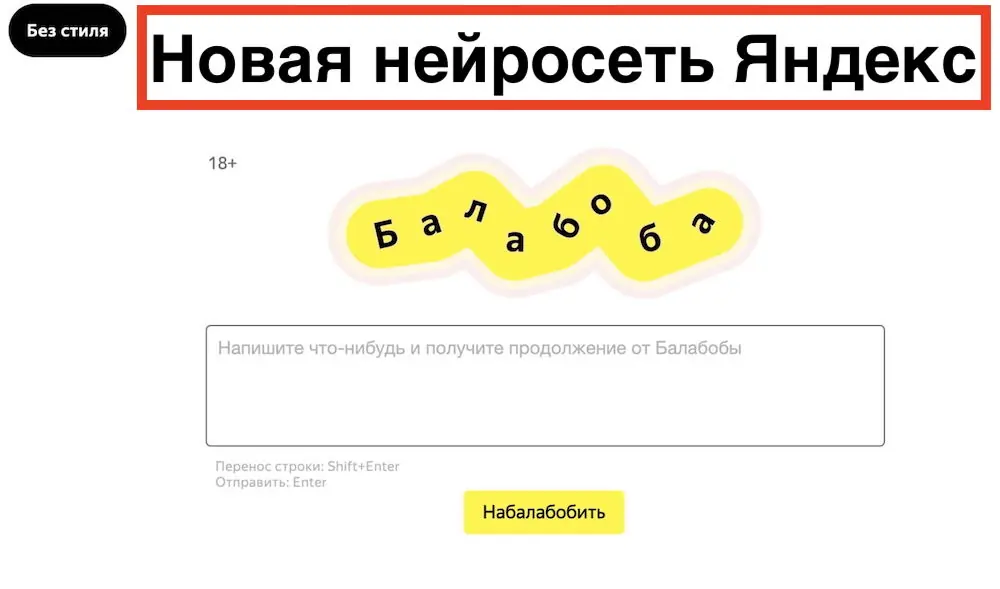

«Балабоба» — новый сервис Яндекса, про который летом 2021 года написали все профильные издания, — сегодня встречает посетителя короткой надписью: «Балабоба на заслуженном отдыхе». Сервис выключен, страница осталась. И это самая честная иллюстрация того, что произошло с генерацией текстов за пять лет: аттракцион закрыли, технология выросла в отдельный класс инструментов, а вопрос, ради которого владельцы сайтов вообще открывали «Балабобу», никуда не делся. Вопрос звучит так: можно ли поручить нейросети писать тексты для сайта и что за это будет в поиске.
В SEO я с 2005 года и застал три волны «убийц копирайтеров»: синонимайзеры, генераторы по цепям Маркова и большие языковые модели. Первые две волны закончились одинаково — массовыми фильтрами у тех, кто поверил в кнопку. Третья волна отличается принципиально: текст на выходе действительно читается как человеческий. Именно поэтому ошибиться стало проще, а цена ошибки выросла. Ниже — что представляла собой «Балабоба», чем её заменили, как поисковики сегодня относятся к машинному тексту и какой порядок работы не приводит к потере трафика.
Чем была «Балабоба» и почему её выключили
«Балабоба» работала на языковой модели семейства YaLM — Yet another Language Model. Механика простая: пользователь вводил начало фразы, выбирал стиль из готового набора — от народной мудрости до заголовков новостей — и модель дописывала продолжение. Ни вопросов, ни инструкций, ни проверки фактов сервис не понимал. Он продолжал текст, опираясь на статистику языка, и делал это с интонацией выбранного жанра.
Яндекс не выдавал это за инструмент для работы. На самой странице висело предупреждение: нейросеть не знает, что говорит, и ответственность за использование написанного лежит на пользователе. Формулировка была не юридической отпиской, а точным описанием природы модели того поколения.
Для сайта из этого следовала нулевая практическая ценность. Текст выходил связным по форме и пустым по содержанию: без структуры, без фактов, без ответа на запрос. Публикация такого материала вела не в топ, а под понижение за малополезный контент — ровно как за рерайт из двухтысячных, только быстрее по скорости производства.
Весной 2022 года сервис отключили. Официальное объяснение на странице проекта звучит без драматизма: «Балабобу» создали в 2021 году, чтобы показать возможности первой версии YaLM, а технология с тех пор ушла далеко вперёд. Взамен предлагают Алису, Яндекс Браузер и «Шедеврум». Летом того же 2022 года Яндекс выложил в открытый доступ YaLM 100B — модель на сто миллиардов параметров, — и на этом история демонстрационного генератора закончилась окончательно.
Смена поколений заняла примерно три года и шла заметными шагами. В мае 2023 года Яндекс представил YandexGPT и встроил её в Алису — впервые появилась модель, которая понимает инструкцию, а не просто дописывает фразу. Летом того же года добавили память контекста: диалог перестал начинаться каждый раз с чистого листа.
16 апреля 2024 года запустили «Нейро» — сервис, который берёт вопрос, сам подбирает источники в поисковой выдаче, читает их и собирает связный ответ со ссылками на использованные материалы. В октябре 2024 года «Нейро» перестал быть отдельным продуктом и переехал в обычный поиск. Тогда же вышло четвёртое поколение YandexGPT, а в феврале 2025 года — пятое, в вариантах Lite и Pro, позже дополненное флагманской версией. Часть возможностей платного уровня со временем открыли всем пользователям Алисы.
| Поколение | Годы | Что умеет | Применимость к текстам сайта |
|---|---|---|---|
| «Балабоба» на YaLM | 2021–2022 | Продолжает введённую фразу в выбранном стиле | Никакой: нет задачи, нет структуры, нет фактов |
| YandexGPT в Алисе | с 2023 | Следует инструкции, держит контекст диалога | Черновик, план, переформулировка — под правку человеком |
| «Нейро» и поиск с ИИ-ответом | с 2024 | Ищет источники, читает их, отвечает со ссылками | Сбор фактуры и проверка, но с обязательной сверкой |
| YandexGPT 5 и старше | с 2025 | Длинный контекст, работа с файлами, режим рассуждений | Обработка массивов данных, таблицы, структурирование |
Разница между строками этой таблицы огромна по возможностям и почти нулевая по одному пункту: риск для сайта при публикации без доработки остался прежним. Более того, он вырос. «Балабобу» невозможно было принять за автора — бессмыслица бросалась в глаза с первого абзаца. Современная модель выдаёт гладкий, уверенный, правдоподобный текст, который легко принять за готовый и залить пачкой на пятьдесят страниц.
Тему разбирал отдельно: «Новый апдейт Яндекса перетасовал ТОП. Пока все в панике — самое время рвануть вверх».
Почему модель уверенно пишет неправду
Языковая модель не хранит факты в виде базы данных. Она хранит статистику языка: какие последовательности слов встречались вместе и с какой вероятностью. Ответ строится пословно, каждое следующее слово выбирается как наиболее вероятное продолжение. У такого механизма нет внутреннего различия между «я знаю» и «так обычно пишут».
Отсюда типичная ошибка, которую в отрасли называют галлюцинацией: модель придумывает правдоподобную деталь и подаёт её тем же тоном, что и проверенный факт. В текстах для сайта это выглядит как несуществующий пункт закона, выдуманное название стандарта, неверная дата запуска сервиса, ссылка на исследование, которого не было, или цена, взятая из воздуха.
Инструменты, которые ищут по интернету перед ответом — «Нейро», Алиса с поиском, режимы с веб-доступом, — эту проблему уменьшают, но не снимают. Модель опирается на найденные страницы, а страницы в выдаче тоже бывают неточными и устаревшими. Плюс сам пересказ может исказить исходный смысл: то, что в источнике было оговоркой, в сводке легко превращается в утверждение.
Практический вывод один и он не зависит от версии модели: всё, что можно проверить, надо проверять. Даты, цифры, названия, цены, нормативные ссылки, характеристики товаров и любые утверждения вида «по данным исследования» проходят сверку по первоисточнику до публикации, а не после жалобы читателя.
Как поисковики на самом деле относятся к ИИ-текстам
Публичная позиция Яндекса сформулирована коротко: важно качество контента, а не способ его создания. Нейросеть считается помощником автора, который не должен подменять автора. Одновременно поиск усиливает алгоритмы против неоригинального контента — скопированного, низкокачественно переписанного, полученного автоматическим переводом. Всё это относится к малополезному контенту, за который сайт теряет позиции. Отдельно с 2017 года работает «Баден-Баден» — санкция за переоптимизированные тексты, написанные ради ключевых слов.
О границе между оптимизацией и нарушением:
У Google формулировки другие, суть та же. Система полезного контента, появившаяся в 2022 году и с марта 2024 года встроенная в основной алгоритм, целится в материалы, созданные в первую очередь для поисковика. В спам-политиках есть отдельный пункт про масштабное производство страниц: наказывается сам факт массового создания малополезного контента, независимо от того, сделан он автоматом, руками или смешанным способом.
Смежный материал по теме — «Как обмануть сервис Pagespeed insights».
| За что понижают | За что не понижают |
|---|---|
| Массовая заливка однотипных страниц под запросы | Использование модели как черновика с последующей правкой |
| Текст без новой информации по сравнению с выдачей | Материал с личным опытом, где ИИ помог со структурой |
| Фактические ошибки и выдуманные данные | Проверенная фактура, пусть и собранная с помощью ИИ |
| Переспам ключами и вода ради объёма | Точный ответ на запрос без искусственного растягивания |
| Отсутствие автора и подтверждаемого опыта | Понятное авторство, экспертиза, ссылки на источники |
Обратите внимание на логику: во втором столбце везде фигурирует человек, который что-то добавил и за что-то поручился. Алгоритмы не ищут «следы нейросети» как таковые — детекторы ИИ-текста ненадёжны, и строить санкции на них было бы странно. Они оценивают результат: приносит страница пользователю новое или нет.
Где нейросеть реально экономит время в SEO
Отказываться от инструмента из-за рисков — та же крайность, что генерировать им сайт целиком. Есть задачи, где модель даёт выигрыш в разы и почти не создаёт опасности, потому что результат легко проверяется глазами.
| Задача | Выигрыш | Что проверяет человек |
|---|---|---|
| План статьи и список подзаголовков | Высокий | Полноту относительно реального спроса |
| Черновик раздела по своим тезисам | Высокий | Каждый факт и весь тон изложения |
| Кластеризация и чистка семантики | Высокий | Логику групп и мусорные запросы |
| Описания карточек по характеристикам | Средний | Соответствие реальным свойствам товара |
| Черновики title и description | Средний | Длину, вхождение запроса, отсутствие клише |
| Разбор выгрузок из Вебмастера и Метрики | Высокий | Корректность расчётов и выводов |
| Экспертная часть текста | Нулевой | Пишется человеком, у модели этого опыта нет |
Закономерность видна: выигрыш максимален там, где нужна скорость обработки, и падает до нуля там, где нужен опыт. Модель отлично приводит в порядок список из тысячи запросов и совершенно не может рассказать, что произошло на конкретном проекте после переноса сайта на другой движок.
Рабочий порядок: модель готовит сырьё, человек отвечает за смысл
Схема, которая не приводит к потере трафика, устроена одинаково для любой модели — YandexGPT, Алисы или любого другого ассистента. Нейросеть работает на входе и в середине, финальные решения остаются за человеком.
| Этап | Делает модель | Делает человек |
|---|---|---|
| Спрос | Предлагает вопросы аудитории и варианты структуры | Сверяет с Вордстатом и реальными запросами |
| Фактура | Собирает и систематизирует найденное | Проверяет по первоисточникам, отбрасывает лишнее |
| Черновик | Пишет заготовку по утверждённому плану | Переписывает под свой опыт и свою интонацию |
| Экспертиза | Не участвует | Добавляет разбор ситуаций, ограничения, выводы |
| Вычитка | Может предложить сокращения | Убирает воду, решает, что публиковать |
Отдельно про промты. Разница между бесполезным и полезным черновиком почти всегда в объёме входных данных. Запрос «напиши статью про утепление фасада» даёт средний по интернету текст, который уже есть у сотни сайтов. Запрос, где заданы аудитория, регион, ограничения, ваши тезисы, запрещённые формулировки и структура разделов, даёт заготовку, которую есть смысл править. Модель не придумывает содержание — она перекладывает то, что вы в неё положили.
Как проверить текст перед публикацией
Короткий список, по которому проходит любой материал, где участвовала нейросеть. Он занимает пятнадцать минут и снимает большую часть рисков.
- Каждое число, дата и название сверены с первоисточником. Формулировка «по данным исследования» без ссылки удаляется.
- В тексте есть хотя бы один блок, которого нет у конкурентов: разбор ситуации, порядок действий, критерии выбора, честное ограничение.
- Первый абзац отвечает на запрос, а не разогревается. Если начало можно удалить без потери смысла — его надо удалить.
- Нет фраз-пустышек: «в современном мире», «играет важную роль», «стоит отметить, что». Модель тянется к ним по статистике языка.
- Заголовки описывают содержание раздела, а не повторяют запрос с разными окончаниями.
- Текст читается вслух без спотыканий. Однотипный ритм предложений — характерный признак невычитанной генерации.
- Указан автор, у которого есть отношение к теме. Анонимная статья на коммерческом сайте сегодня проигрывает подписанной.
Главное изменение: нейросети переделали не тексты, а выдачу
Пока рынок спорил, писать ли статьи нейросетью, произошло изменение поважнее. Часть пользователей перестала переходить на сайты: они получают ответ прямо в поиске — в ИИ-сводке, в блоке «Нейро», в диалоге с ассистентом. Запрос закрыт, клика нет.
Если нужны детали, смотрите «Влияет ли Яндекс Метрика на ранжирование | Новый эксперимент».
Это бьёт неравномерно. Простые справочные запросы вида «сколько сохнет шпаклёвка» теперь закрываются в выдаче почти полностью. Запросы, где нужен выбор, сравнение, цена, расчёт или покупка, по-прежнему ведут на сайты — короткого ответа для них недостаточно. Отсюда практический сдвиг в семантике: делать ставку только на справочные микрозапросы стало заметно менее выгодно, чем три года назад.
Второе следствие — попадание в источники ИИ-ответа стало отдельной задачей. Сводка собирается из страниц выдачи и ссылается на них, а значит, у сайта появился новый способ получить видимость и переходы. Требования при этом совпадают с обычным SEO: понятная структура, прямые ответы на конкретные вопросы, факты и цифры, которые можно процитировать, отсутствие воды вокруг сути. Материал, написанный так, чтобы из него было удобно взять абзац, одинаково нравится и читателю, и модели.
Ошибки, которые заканчиваются потерей трафика
Перечислю то, что чаще всего приводит сайты в состояние, из которого выбираться дороже, чем было бы написать нормально сразу.
- Массовая заливка. Пятьдесят статей за выходные по одному шаблону — самый заметный для алгоритмов сигнал. Скорость появления однотипных страниц отслеживается легко.
- Генерация под каждый запрос. Отдельная страница на «купить кран шаровой 15» и «купить кран шаровой 20» с переставленными словами создаёт дубли, а не покрытие спроса.
- Ставка на процент уникальности. Технически уникальный текст без новой информации бесполезен. Уникальность проверяет совпадение символов, а не ценность.
- Публикация без вычитки. Ошибку в цифре читатель заметит быстрее алгоритма, и потеря доверия обойдётся дороже позиций.
- Замена автора моделью. Если на сайте эксперта тексты пишет ассистент, экспертность исчезает вместе с причиной, по которой сайту доверяли.
- Попытка чистить задним числом. Разгребать сотню слабых страниц дольше и дороже, чем написать двадцать хороших. Проверено не раз.
Частые вопросы
«Балабоба» ещё работает? Нет. Сервис отключили весной 2022 года, на его странице висит сообщение об отдыхе и предложение перейти к современным нейросетям Яндекса. Он изначально создавался как демонстрация первой версии YaLM, а не как рабочий инструмент.
Чем YandexGPT отличается от «Балабобы»? Это разные поколения технологии. «Балабоба» продолжала введённую фразу в заданном стиле и не понимала задачу. YandexGPT следует инструкции, держит контекст диалога, работает с файлами и длинным текстом. Сравнивать их по качеству примерно так же осмысленно, как калькулятор и таблицу в редакторе.
Яндекс понижает сайты за тексты нейросети? Понижают не за инструмент, а за результат. Публичная позиция поиска — важно качество, а не способ создания. Под санкции попадает малополезный, шаблонный, переспамленный контент вне зависимости от того, кем он написан.
Можно ли вывести сайт в топ на текстах от нейросети? На сырых, опубликованных без доработки — нет. На материалах, где модель сделала черновик, а человек добавил фактуру, опыт и структуру, — да, и это обычная рабочая практика. Разница не в инструменте, а в объёме вложенной головы.
Детекторы ИИ-текста работают? Ненадёжно. Они ошибаются в обе стороны: помечают живой текст как машинный и пропускают отредактированную генерацию. Ориентироваться на их процент при приёмке текста бессмысленно, проверять надо содержание.
Как понять, что текст пора переписать? Откройте страницу и спросите: что читатель узнает здесь такого, чего нет на первых пяти сайтах выдачи. Если ответа нет — текст не работает, независимо от того, кто его писал. Показы в Вебмастере обычно подтверждают этот вывод в течение месяца.
Коротко
- «Балабоба» была демонстрацией первой версии YaLM: продолжала фразу в заданном стиле, не понимала задачу и не проверяла факты. Сервис выключили весной 2022 года.
- На смену пришли YandexGPT, Алиса и «Нейро» — модели, которые следуют инструкции и опираются на источники. Возможности выросли, риск бездумной публикации вырос вместе с ними.
- Языковая модель предсказывает вероятное продолжение, а не хранит факты, поэтому даты, цифры и названия сверяются с первоисточником всегда.
- Поисковики понижают не за использование ИИ, а за результат: массовые однотипные страницы без новой информации, переспам, выдуманные данные.
- Выигрыш от модели максимален на рутине — план, кластеризация, обработка выгрузок — и равен нулю там, где нужен реальный опыт.
- Часть запросов теперь закрывается ИИ-ответом без перехода, поэтому ценность справочных микрозапросов упала, а попадание в источники сводки стало отдельной задачей.
Если непонятно, что делать с уже опубликованным массивом машинных текстов или с какого объёма контента вообще начинать в вашей нише, приходите на SEO-консультацию: посмотрим сайт и статистику Вебмастера вместе, отделим страницы, которые тянут домен вниз, от тех, что можно дорабатывать.
Увеличьте позиции и продажи вашего сайта
Профессиональное SEO-продвижение с гарантией результата. Выберите подходящую услугу:
Остались вопросы по продвижению?
Меня зовут Анатолий Кузнецов, я SEO-оптимизатор с 20-летним стажем. Разберу ваш сайт, отвечу на вопросы и подскажу, что улучшить для роста позиций в Яндексе и Google.
Связаться со мной → Старт
 Стандарт
 Премиум



Комментарии
Виталий Жуйков
Залил в прошлом году сто двадцать статей, сгенерированных пачкой. Полгода всё индексировалось и даже показы росли, потом за пару месяцев трафик сложился почти вдвое, причём просели и старые страницы, которых генерация не касалась. Вот этого эффекта я не ожидал совсем.
Анатолий Кузнецов автор
Просадка старых страниц — обычное продолжение такой истории, и она пугает сильнее самого падения. Оценка полезности работает не только постранично: если большая доля документов домена не приносит пользователю нового, доверие снижается ко всему сайту. Порядок действий такой. Выгрузите из Вебмастера показы и клики по всем URL за последние девять месяцев и отсортируйте по нулевым. Страницы, которые за это время не набрали ни одного клика и не имеют входящих ссылок, закрывайте от индексации или удаляйте с 410 — не переписывайте, это дороже. Оставшиеся разбейте на группы по темам и переписывайте по одной группе в месяц, добавляя фактуру. Восстановление занимает от трёх до шести месяцев и идёт волнами, резкого возврата ждать не стоит.
Оксана Железняк
Жалко Балабобу, конечно. Она была бесполезная, но смешная — мы ей заголовки для внутренних презентаций генерировали. Нынешние модели умнее и скучнее.
Пётр Зябликов
Не соглашусь с тезисом про детекторы. У нас редакция платит за тексты, и без проверки авторы просто сдают генерацию под видом своей работы. Пусть детектор ошибается, но он хотя бы что-то ловит. Чем предлагаете заменить?
Анатолий Кузнецов автор
Проблема реальная, но детектор её не решает — он решает соседнюю. Автор, который прогнал генерацию через переписывание, пройдёт проверку, а честный текст с ровным ритмом может её не пройти, и вы поссоритесь с нормальным исполнителем. Работает другой приём: стройте техническое задание так, чтобы генерация физически не проходила приёмку. Требуйте в каждом материале то, чего у модели нет — ссылку на первоисточник по каждой цифре, скриншот из интерфейса или отчёта, комментарий практика, разбор конкретной ситуации с деталями. Плюс задавайте автору два-три вопроса по содержанию сданного текста. Человек, который писал сам, отвечает мгновенно, а тот, кто нажал кнопку, начинает плавать. Это дешевле подписки на детектор и точнее.
Наталья Иноземцева
Спасибо за хронологию, наконец-то в одном месте. Постоянно путалась, что было раньше — Нейро или пятая версия модели.
Артур Жиляев
Вопрос про карточки товара. У нас четыре тысячи позиций, описания писать вручную нереально ни по деньгам, ни по срокам. Генерация по характеристикам — это тоже массовая заливка со всеми последствиями или всё-таки другой случай?
Анатолий Кузнецов автор
Другой случай, если соблюдены условия. Карточка товара оценивается не как статья: пользователю нужны характеристики, наличие, цена, фото и условия доставки, а текст там вспомогательный. Генерация описаний из реальных характеристик товара — это не выдумывание контента, а переупаковка существующих данных, и претензий она обычно не вызывает. Ломается всё в трёх местах. Первое: если модель добавляет свойства, которых у товара нет, — получаете фактическую ложь на четырёх тысячах страниц. Второе: если шаблон один и меняются только подставленные слова — рискуете получить массив почти одинаковых документов. Третье: если в карточке нет ничего, кроме сгенерированного абзаца. Практический порядок — жёсткий шаблон только для полей из базы, разное строение текста для разных категорий и обязательные блоки с ответами на вопросы покупателей по этой группе товаров.
Марина Заварзина
Про промты в точку. Пока писала «сделай статью про», получала одинаковую воду. Стала давать модели свои тезисы и запрет на определённые обороты — черновик стал пригодным к правке, а не к удалению.
Родион Изместьев
По поводу нулевых кликов. У меня блог про ремонт техники, три четверти запросов справочные. Получается, направление можно закрывать? Или есть что-то, что удерживает переход даже на простом вопросе?
Анатолий Кузнецов автор
Закрывать не надо, надо перестраивать тип материалов. Уходят в ноль запросы с одним коротким верным ответом: код ошибки, размер детали, срок сушки. Остаются те, где ответ зависит от условий и требует действий. Для блога про ремонт это означает сдвиг к разборам полной последовательности с фотографиями каждого шага, к таблицам совместимости конкретных моделей, к сравнению вариантов ремонта по стоимости, к спискам инструмента с ценами. Сводка такое не заменяет — там нужен объём, порядок и картинки. Второй ход: превращайте справочную часть в инструмент. Калькулятор, подбор детали по номеру, таблица с фильтром удерживают пользователя на странице и дают то, что ИИ-ответ в принципе не отдаёт.
Алевтина Жернакова
Пункт про однотипный ритм предложений — очень точное наблюдение. Заметила у себя в текстах после правки генерации: все абзацы по три предложения одинаковой длины. Стала специально ломать.
Семён Звонарёв
Смущает совет удалять страницы с 410. Их же индексировали, там какой-то вес накоплен. Не проще поставить редирект на близкий раздел и сохранить хоть что-то?
Анатолий Кузнецов автор
Зависит от того, что именно накоплено. Редирект оправдан, когда у страницы есть входящие внешние ссылки, есть переходы из закладок или она набирала показы по своей группе запросов — тогда вы переносите реальный сигнал. Если страница за девять месяцев не собрала ни кликов, ни ссылок, переносить нечего: вы просто склеиваете пустоту с работающим разделом и вдобавок создаёте массив редиректов, который придётся обслуживать. Есть и третий вариант между ними — оставить страницу в индексе, но объединить пять близких слабых материалов в один сильный, а старые адреса склеить редиректами на него. Так делают, когда темы действительно смежные. Проверяйте по каждой группе отдельно, единого правила тут нет.
Дарья Игумнова
Интересно, что Яндекс сам открыл YaLM в свободный доступ. Получается, компания раздала технологию, которой потом завалили выдачу мусорными текстами. Забавная петля.
Кирилл Ильюшин
Мы переводим англоязычные исследования нейросетью и редактируем. Долго спорили, не считается ли это машинным переводом, за который понижают. В итоге пришли к тому же выводу, что в статье: чистый перевод не тянет, а перевод плюс свой разбор применимости к российским ценам и правилам работает нормально.
Тамара Жолобова
Проверила свои старые тексты по списку из статьи. Половина начинается с разогрева на два абзаца, который можно выкинуть без потерь. Пойду выкидывать, спасибо за пинок.