




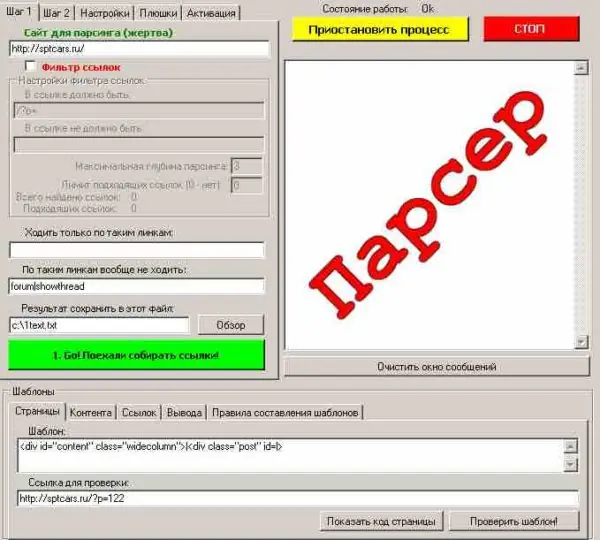

Программа-парсер сайтов превращает работу, на которую вручную уходит неделя, в задачу на сорок минут: обойти три тысячи страниц каталога, выгрузить все заголовки и метатеги, найти дубли и пустые описания. Без такого инструмента технический аудит сводится к выборочному просмотру десятка страниц и надежде, что остальные в порядке — а они не в порядке почти никогда.
За годы работы с сайтами я перепробовал десятки таких программ и пришёл к простому выводу: выбор инструмента вторичен, первичен вопрос, какие данные вам нужны и что вы с ними сделаете. Ниже — как устроен парсинг, какие типы программ существуют, под какие задачи брать какой класс инструментов, где законные границы и как не убить чужой сервер запросами.
Как работает парсер: три этапа
Внутри любой программы-парсера происходит одна и та же последовательность, независимо от интерфейса и цены.
- Обход. Программа берёт стартовый адрес, скачивает страницу, находит в коде все ссылки и добавляет их в очередь. Затем повторяет процедуру для каждой ссылки из очереди, пока не закончатся новые адреса. Так строится карта сайта.
- Загрузка. По каждому адресу выполняется запрос, программа получает код ответа сервера и HTML-код страницы. На этом же этапе фиксируются время ответа, размер страницы, редиректы.
- Извлечение. Из полученного кода по заданным правилам вытаскиваются нужные фрагменты: содержимое тега title, заголовки, цены, характеристики, ссылки. Правила задаются CSS-селекторами, выражениями XPath или регулярными выражениями.
Практическое следствие первого этапа: парсер видит только те страницы, на которые есть ссылки. Если раздел каталога доступен лишь через фильтр на JavaScript и обычной ссылки на него нет, программа его не найдёт — и поисковый робот, кстати, чаще всего тоже. Расхождение между числом страниц в базе сайта и числом найденных краулером — сам по себе диагноз.
Второе следствие: современные сайты часто подгружают содержимое скриптами. Простой парсер получит пустой каркас страницы. Для таких проектов нужен инструмент, умеющий выполнять JavaScript через встроенный браузер — он медленнее в разы, но видит страницу так же, как посетитель.
Типы парсеров и под какие задачи они нужны
| Тип программы | Что собирает | Типичная задача | На что смотреть при выборе |
|---|---|---|---|
| SEO-краулер структуры | Коды ответа, метатеги, заголовки, ссылки, вложенность, редиректы | Технический аудит сайта | Лимит страниц, поддержка JavaScript, настройка скорости обхода |
| Парсер выдачи | Позиции, состав топа, сниппеты, наличие рекламы | Анализ конкуренции и кластеризация запросов | Наличие прокси, поддержка регионов, стоимость проверки |
| Сборщик семантики | Подсказки, частотности, связанные запросы | Сбор ядра | Источники данных, скорость, съём частотности с уточнениями |
| Парсер товаров и цен | Названия, артикулы, цены, наличие, характеристики | Мониторинг рынка, наполнение каталога | Работа с пагинацией, обход защиты, расписание запусков |
| Универсальный визуальный парсер | Что угодно по заданным селекторам | Разовые нестандартные выгрузки | Простота настройки, экспорт, работа с авторизацией |
| Библиотеки для разработчика | Что угодно, но программируется | Регулярные автоматизированные задачи | Порог входа, поддержка асинхронности |
Для большинства владельцев сайтов достаточно двух инструментов: краулера структуры и сборщика семантики. Всё остальное — задачи под конкретный случай, и покупать их заранее смысла нет.
Что искать краулером в первую очередь
Первый прогон по своему сайту почти всегда выдаёт больше находок, чем ожидается. Порядок разбора результатов лучше держать одинаковым — так ничего не теряется.
| Что смотрим в выгрузке | Признак проблемы | Почему это важно |
|---|---|---|
| Коды ответа | Страницы с ответом 404 и 5xx среди внутренних ссылок | Тупики для робота и посетителя, потеря веса |
| Редиректы | Цепочки из двух и более переходов | Замедление обхода, часть сигналов теряется |
| Title | Пустые, одинаковые, длиннее 70 символов | Плохие сниппеты и низкий процент кликов |
| Description | Отсутствует или скопирован на сотни страниц | Поисковик собирает сниппет случайным образом |
| Заголовки H1 | Ни одного или несколько на странице | Размывается тема страницы |
| Канонические адреса | Указывают на другую страницу или отсутствуют на фильтрах | В индекс попадает не та страница |
| Вложенность | Страницы глубже четвёртого уровня от главной | Робот доходит до них редко |
| Объём текста | Страницы с парой предложений | Кандидаты на исключение как малополезные |
| Время ответа сервера | Больше секунды на значимой доле страниц | Ограничивает скорость обхода и вредит позициям |
Отдельный приём: сравнить список адресов из выгрузки краулера со списком страниц, участвующих в поиске, по данным Вебмастера. Разница в обе стороны информативна. Страницы, которых нет в поиске, — проблема индексации. Страницы, которых нет у краулера, но есть в поиске, — обычно старые адреса, забытые версии или мусор, оставшийся после переноса.
Тему разбирал отдельно: «Allsubmitter — что это за программа».
Парсинг конкурентов: что реально полезно
Смотреть чужие сайты полезно не ради копирования, а ради понимания, из чего складывается страница, которая стоит выше вас. Данные, которые окупают время на сбор.
- Структура каталога. Выгрузка всех адресов конкурента показывает, какие категории и подкатегории у него есть, а у вас нет. Это самый быстрый способ найти пробелы в структуре.
- Состав карточки товара или страницы услуги. Какие блоки присутствуют: характеристики, отзывы, вопросы, доставка, сопутствующие товары.
- Заголовки и метатеги. По ним видно, под какие формулировки конкурент оптимизирует страницы.
- Ассортимент и цены. Для товарных ниш это прямая коммерческая информация.
- Объём и структура текстов на страницах топа. Ориентир по полноте раскрытия темы, а не повод копировать.
- Программы для SEO продвижения
- Как найти хорошего программиста
- ИИ-агент для своего бизнеса: что реально собрать без программиста и чего он не сделает
Чего делать не стоит: выкачивать чужие описания товаров и ставить их у себя. Это не только вопрос авторских прав — дублированные описания не дают ничего для позиций, потому что такой текст уже существует в индексе и не добавляет странице ценности.
Сбор семантики через парсинг
Сбор запросов — вторая по частоте задача после аудита. Источников несколько, и надёжнее использовать их вместе.
- Базовые слова: выписываете, как называется ваш товар или услуга, включая профессиональные и разговорные варианты.
- Расширение: подсказки поисковой строки, левая и правая колонки Вордстата, связанные запросы внизу выдачи.
- Частотность: съём базовой и уточнённой частоты по каждой фразе — без уточнённой частоты вы будете принимать решения по завышенным цифрам.
- Чистка: удаление запросов с чужими брендами, городами не вашего региона, нерелевантными добавками.
- Кластеризация: группировка по составу выдачи, чтобы понять, сколько нужно страниц и каких.
- Сверка с реальностью: отчёт поисковых запросов в Метрике и Вебмастере показывает, по чему к вам уже приходят.
Инструменты для этих шагов: Вордстат, Мегаиндекс, Rush Analytics, Topvisor. Последние два умеют и снимать частотность, и кластеризовать по топу, что экономит основную часть времени.
Границы: что законно, а что нет
Парсинг сам по себе — это те же запросы к сайту, что делает обычный браузер, и они не запрещены. Проблемы начинаются в трёх местах.
- Нагрузка. Агрессивный обход в много потоков без пауз может положить чужой сайт. Это уже нарушение работы информационной системы, и относиться к этому нужно серьёзно.
- Объекты авторского права. Тексты, фотографии, видео защищены, и их копирование к себе — нарушение независимо от того, как вы их получили.
- Персональные данные. Сбор контактов физических лиц из открытых источников для рассылок регулируется отдельно и почти всегда незаконен без согласия.
- Программы для SEO продвижения
- Как найти хорошего программиста
- ИИ-агент для своего бизнеса: что реально собрать без программиста и чего он не сделает
Отдельно про базы данных: содержимое каталога может охраняться как база данных, и массовое извлечение существенной части такого каталога — предмет судебных споров. Факты вроде цены и наличия товара авторским правом не охраняются, но добросовестность в сборе всё равно нужна.
Правила разумного парсинга простые и почти всегда игнорируются новичками.
| Параметр | Разумная настройка | Что бывает при перегибе |
|---|---|---|
| Число потоков | 2-5 для чужого сайта, больше — только для своего | Замедление или падение сервера, блокировка адреса |
| Пауза между запросами | От 0,5 секунды | Срабатывание защиты от нагрузки |
| Время запуска | Ночные часы низкой посещаемости | Влияние на реальных посетителей |
| Учёт robots.txt | Соблюдать при обходе чужих сайтов | Спорные ситуации и претензии владельца |
| User-agent | Указывать честно, не маскироваться под поискового робота | Обман систем аналитики и защиты |
| Глубина обхода | Ограничивать нужными разделами | Часы работы ради ненужных данных |
Про свой сайт отдельное предупреждение: обход в двадцать потоков на слабом хостинге кладёт сайт не хуже чужого. Если хотите проверить, как сервер держит нагрузку, начните с двух потоков и следите за временем ответа в отчёте краулера — оно начнёт расти раньше, чем сайт упадёт.
Смежный материал по теме — «Semonitor — программа для продвижения сайта».
Парсинг выдачи: что даёт анализ топа
Отдельный класс задач — собрать не сайт, а результаты поиска по списку запросов. Это нужно, чтобы понять, с кем вы конкурируете и какая страница вообще должна стоять по каждому запросу.
| Что снимаем из выдачи | Какой вывод даёт |
|---|---|
| Типы страниц в топ-10 | Категория, карточка, статья или агрегатор — определяет, какую страницу делать вам |
| Доля агрегаторов и маркетплейсов | Оценка реалистичности выхода в топ собственным сайтом |
| Пересечение выдач у двух фраз | Основание объединять запросы в одну группу или разводить по страницам |
| Возраст и объём страниц из топа | Ориентир по глубине проработки темы |
| Наличие блоков с картой, картинками, видео | Подсказка, какой формат содержимого нужен странице |
| Число рекламных объявлений сверху | Косвенный признак денег в нише и высоты конкуренции |
Снимать выдачу нужно с привязкой к региону и обязательно без учёта личной истории посещений: результаты в обычном браузере искажены персонализацией и вводят в заблуждение чаще, чем помогают. Ещё одна деталь: снимать топ по одним и тем же запросам стоит регулярно, раз в месяц. Изменение состава выдачи — ранний сигнал того, что алгоритм переоценил тип страниц по вашей теме, и реагировать на него лучше до просадки, а не после неё.
Как выбрать программу под свою задачу
Порядок вопросов, на которые стоит ответить до выбора.
- Сколько страниц нужно обойти? До нескольких сотен подойдёт почти любой бесплатный инструмент, от десятков тысяч — вопрос лимитов и оперативной памяти.
- Нужен ли JavaScript? Если содержимое подгружается скриптами, инструмент без встроенного браузера бесполезен.
- Разовая задача или регулярная? Для регулярной нужны расписание и автоматический экспорт, для разовой хватит настольной программы.
- Требуется ли авторизация? Не все программы умеют работать за формой входа.
- Куда пойдут данные? Если в таблицу для просмотра — достаточно экспорта, если в систему — нужен доступ через программный интерфейс.
- Каков бюджет? Многие задачи закрываются бесплатными версиями с ограничением по числу страниц.
Практический совет: не начинайте с покупки. Прогоните бесплатную версию по своему сайту, посмотрите, каких данных не хватает, и только потом решайте, за что имеет смысл платить. В большинстве случаев выясняется, что проблема не в инструменте, а в том, что найденное некому исправлять.
Что делать с полученными данными
Если нужна помощь по теме — мой курс по SEO.
Выгрузка на десять тысяч строк сама по себе бесполезна. Работающая схема — превращать её в список задач с приоритетом.
Если нужны детали, смотрите «SEO анализ продвижение сайтов».
- Сначала то, что мешает индексации: недоступные страницы, ошибки сервера, неверные канонические адреса.
- Затем массовые проблемы: одинаковые метатеги на сотнях страниц, отсутствие H1, пустые категории.
- Потом точечные: битые ссылки, длинные цепочки редиректов, тяжёлые страницы.
- Отдельным списком — то, что требует контента: страницы без описаний, категории без текста, карточки с пустыми характеристиками.
- Всё, что можно исправить шаблоном движка, исправляется шаблоном, а не вручную по страницам.
- Программы для SEO продвижения
- Как найти хорошего программиста
- ИИ-агент для своего бизнеса: что реально собрать без программиста и чего он не сделает
Повторный прогон через две недели после правок обязателен: он показывает, что реально исправлено, а что осталось на словах. Это же лучший способ проверить работу подрядчика по техническому аудиту.
Частые вопросы
Можно ли парсить сайты бесплатно? Да, для небольших объёмов. Бесплатные версии краулеров обычно ограничены несколькими сотнями страниц за прогон, чего хватает для сайта услуг. Для каталога на десятки тысяч страниц потребуется платная версия или разбиение обхода по разделам.
Заметит ли владелец сайта, что его парсят? При аккуратных настройках чаще всего нет: запросы выглядят как обычные посещения. При агрессивном обходе — заметит сразу по нагрузке и по аномалиям в аналитике, и почти наверняка заблокирует.
Что делать, если сайт защищён от парсинга? Защита обычно означает, что владелец против. Обходить её через смену адресов и подмену признаков браузера — путь в спорную зону. Для большинства SEO-задач нужные данные доступны и без этого: выдача, подсказки, публичные разделы.
Подходит ли парсер для наполнения интернет-магазина? Для технических характеристик и артикулов — да, это фактические данные. Для описаний и фотографий — нет: они защищены авторским правом и вдобавок не дают преимущества в поиске, потому что уже проиндексированы у источника.
Нужен ли парсер, если сайт маленький? Даже на тридцати страницах прогон краулера занимает минуту и находит вещи, которых не видно глазом: забытый редирект, дубль по адресу с параметром, пустой заголовок на странице контактов. Это дешевле любой другой проверки.
Подробнее — в моём курсе по продвижению сайтов:
Коротко
- Парсер работает в три этапа — обход по ссылкам, загрузка кода, извлечение по правилам; поэтому он видит ровно то, что видит поисковый робот.
- Владельцу сайта хватает двух классов инструментов: краулера структуры для аудита и сборщика семантики для ядра.
- Первый прогон разбирают по порядку: коды ответа, редиректы, метатеги, канонические адреса, вложенность, объём текста, время ответа.
- Сверка списка адресов краулера со страницами в поиске по Вебмастеру находит проблемы индексации быстрее любого другого способа.
- Законные границы проходят по нагрузке, авторскому праву и персональным данным: факты собирать можно, чужие тексты и фото копировать нельзя.
- Ценность даёт не выгрузка, а превращение её в приоритизированный список задач и повторный прогон после правок.
- Программы для SEO продвижения
- Как найти хорошего программиста
- ИИ-агент для своего бизнеса: что реально собрать без программиста и чего он не сделает
Если после прогона краулера получился список из сотен строк и непонятно, за что хвататься первым, приходите на SEO-консультацию — разберём выгрузку по вашему сайту и расставим приоритеты по влиянию на трафик.
Увеличьте позиции и продажи вашего сайта
Профессиональное SEO-продвижение с гарантией результата. Выберите подходящую услугу:
Остались вопросы по продвижению?
Меня зовут Анатолий Кузнецов, я SEO-оптимизатор с 20-летним стажем. Разберу ваш сайт, отвечу на вопросы и подскажу, что улучшить для роста позиций в Яндексе и Google.
Связаться со мной → Старт
 Стандарт
 Премиум



Комментарии
Антон Вершинин
Прогнал краулер по своему магазину впервые за пять лет. 11 тысяч страниц, из них 4 тысячи — карточки с одинаковым description, скопированным из шаблона категории. Никто этого не видел, потому что глазами открывали по три карточки на категорию.
Людмила Карпец
Столкнулась с тем, что краулер нашёл 200 страниц, а в базе движка их 1800. Долго не могла понять, в чём дело. Оказалось, каталог открывается только через фильтр на скриптах, обычных ссылок на подкатегории нет вообще.
Анатолий Кузнецов автор
Вы описали одну из самых дорогих технических проблем, и хорошо, что нашли её сами. Поисковый робот в этой ситуации ведёт себя так же, как ваш краулер: страниц, на которые нет обычных ссылок, для него не существует, и в индекс они не попадают. Решается это не настройками краулера, а изменением сайта. Минимум — вывести подкатегории обычными ссылками в меню или блоком на странице категории. Дальше — сделать карту сайта, куда попадут все адреса, и проверить, как быстро робот их подхватит. И обязательно сравните после этого число страниц в поиске по Вебмастеру через месяц: если оно не растёт, значит страницы находятся, но признаются малоценными, и это уже другая задача — наполнение.
Вячеслав Одинцов
По поводу нагрузки подтверждаю. Запустил обход конкурента в тридцать потоков, через десять минут получил блокировку по адресу, а заодно, кажется, слегка положил им сайт. Ощущение было так себе. Теперь ставлю два потока и запускаю ночью.
Инна Черкасова
Не хватило конкретики про кластеризацию. Собрали ядро на 3000 фраз, а как их правильно разложить по страницам — так и не поняли. Инструмент выдаёт кластеры, но часть выглядит бессмысленно, и непонятно, доверять машине или переразбивать руками.
Анатолий Кузнецов автор
Машине стоит доверять на уровне заготовки, а решение принимать самому. Работает такой порядок. Сначала прогоните кластеризацию с жёстким порогом — когда для объединения нужно совпадение хотя бы четырёх-пяти страниц в топ-10 у обеих фраз. Получите много мелких, но точных групп. Дальше руками объединяйте те, которые вы всё равно собираетесь размещать на одной странице по здравому смыслу. Обратный путь — начинать с мягкого порога и разбивать — работает хуже: слепленные кластеры сложно разделить. Бессмысленные кластеры обычно возникают из двух источников: в ядре остался мусор с чужими брендами и городами, или фраза настолько редкая, что выдача по ней случайна. Первое чистится до кластеризации, второе — просто откладывается в отдельный список низкочастотных дополнений к текстам.
Павел Гущин
Про сверку с Вебмастером — золотой совет. Нашёл у себя 600 страниц в индексе, которых нет на сайте: остатки от старой версии на другом движке, отдают 200 и живут своей жизнью. Пять лет висели, ни разу не задумывался проверить.
Софья Мирошник
Насчёт копирования характеристик у конкурентов всё-таки спорно. У нас поставщик один на весь рынок, характеристики одинаковые физически. Не выдумывать же другие цифры. Как тогда отличаться от сотни магазинов с той же номенклатурой?
Анатолий Кузнецов автор
Характеристики и есть факты, их выдумывать не надо и копировать их нормально: мощность и габариты у всех одинаковые. Проблема начинается с описаний — вот их брать нельзя, и не только по правовым причинам. Отличаться при одинаковой номенклатуре можно тем, чего нет у поставщика: собственные фотографии товара в работе, видео распаковки, ответы на реальные вопросы покупателей прямо в карточке, таблица сравнения с ближайшими моделями, честное указание, кому эта модель не подойдёт. Ещё сильно работает то, что вокруг карточки: сроки доставки в конкретный город, наличие на складе цифрой, условия гарантийного обслуживания. Магазин с сотней одинаковых конкурентов выигрывает не текстом, а полнотой сервисной информации.
Леонид Тарасюк
Добавлю про повторный прогон. Взяли за правило прогонять краулер раз в месяц и сравнивать с прошлой выгрузкой. Половина находок — это то, что сломали сами при обновлениях: новый модуль отзывов наплодил дублей с параметрами, никто не заметил.
Виктория Апанасенко
Вопрос про уточнённую частотность. В Вордстате у фразы 5000 показов в месяц, а с кавычками и восклицательными знаками остаётся 40. Это нормальная разница или значит, что я неправильно снимаю?
Анатолий Кузнецов автор
Снимаете правильно, разница нормальная и очень показательная. Базовая частота 5000 означает сумму всех запросов, куда входят эти слова в любом порядке и с любыми добавками — включая тысячи фраз, к вашей странице отношения не имеющих. Точная частота 40 — это сколько раз вводили именно эту фразу именно в этой форме. Ориентироваться при планировании нужно на неё, иначе вы будете строить прогноз трафика на цифрах, завышенных в сто раз. Но не отбрасывайте фразу с частотой 40: её базовая частота говорит, что вокруг темы есть спрос, просто он размазан по множеству формулировок. Правильный вывод из вашего примера — не «фраза плохая», а «нужно собрать все формулировки этой темы и посмотреть их суммарную точную частоту».
Рустам Гайнуллин
Про правовую часть было бы полезно подробнее. Мы мониторим цены конкурентов ежедневно, юрист говорит про риски, но конкретики не даёт. При этом мониторинг цен — стандартная практика во всей рознице, все так делают.
Анатолий Кузнецов автор
Я не юрист и точную правовую оценку вашей ситуации дать не могу, но границы, по которым обычно проходит спор, назвать полезно. Сама цена — это факт, и фактические сведения авторским правом не охраняются, поэтому мониторинг цен как таковой споров почти не вызывает. Риски возникают в трёх местах: если вы выкачиваете существенную часть каталога, который владелец оформил как охраняемую базу данных; если нагрузка от вашего обхода мешает работе чужого сайта; если вместе с ценами вы забираете описания и фотографии. Практика, которая снижает риск: собирать только те поля, которые вам реально нужны для сравнения, ходить медленно и в непиковые часы, не обходить защиту, не хранить у себя чужие тексты и изображения. Формулировку конкретных рисков всё-таки лучше получить у юриста в письменном виде, а не устно — тогда будет понятно, о чём именно он беспокоится.
Дарья Бельская
Таблица с настройками обхода пригодилась сразу. Раньше запускала как есть по умолчанию, свой же сайт на слабом тарифе ложился, и я думала, что это хостинг плохой. Два потока и пауза — всё работает, обход дольше, но сайт живой.
Фёдор Лукьянчук
Пункт про то, что проблема не в инструменте, а в том, что найденное некому исправлять, попал в точку. У нас лежит аудит на 80 страниц второй год. Купили дорогую программу, сделали выгрузку, а разработчика на правки так и не выделили.
Элина Ветлугина
Полезно про приоритеты в конце. Мы начинали с битых ссылок, потому что их проще всего править, и убили на это месяц. А сотни страниц с неправильным каноническим адресом при этом продолжали выпадать из индекса, и вот это стоило нам трафика.