




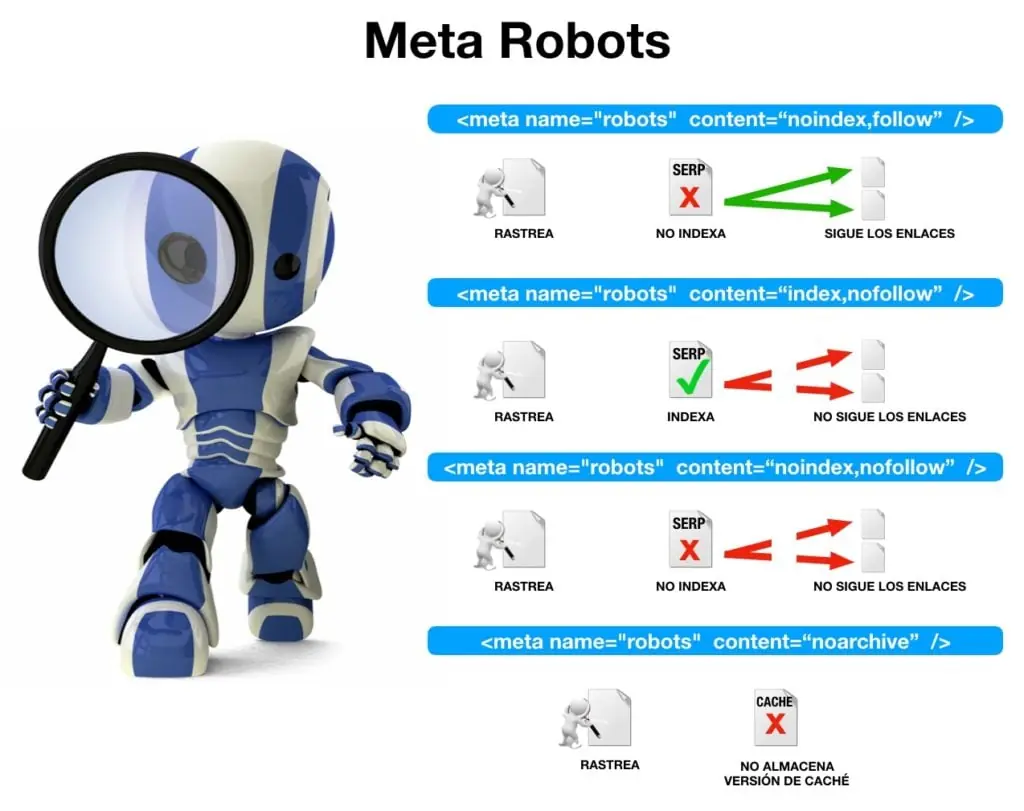

Мета-тег robots и файл robots.txt решают разные задачи, и добрая половина проблем с индексацией начинается ровно там, где их перепутали. Файл управляет обходом: пустит робота на URL или не пустит. Мета-тег управляет индексированием: попадёт ли уже прочитанная страница в базу поиска и пойдёт ли робот по ссылкам с неё. Отсюда следствие, которое ломает логику новичкам: закрыв страницу в robots.txt, вы не уберёте её из выдачи — вы лишите поисковик возможности прочитать указание «убрать».
Ниже — синтаксис обоих инструментов построчно, полный набор значений, порядок разрешения конфликтов между директивами и разбор ошибок, которые я чаще всего нахожу на аудитах. Общее влияние robots.txt на продвижение — отдельная тема, здесь только механика: что писать, куда писать и как убедиться, что написанное сработало.
Границы ответственности: обход против индексирования
Поисковая система выполняет с вашим сайтом два разных действия, и они разнесены во времени. Сначала краулер запрашивает URL по HTTP и получает код ответа с телом документа. Это обход. Потом индексатор разбирает полученный документ, извлекает содержимое и решает, класть ли страницу в базу. Это индексирование.
Файл robots.txt срабатывает на первом шаге. Краулер читает его до того, как обратиться к любому URL хоста, и, если путь запрещён, запроса просто не происходит. Мета-тег robots срабатывает на втором шаге — он находится внутри HTML, а значит, чтобы его увидеть, документ нужно сначала скачать.
Из этой последовательности вытекают все дальнейшие правила. Запрет обхода делает невидимым всё, что находится внутри страницы: мета-теги, канонический адрес, редирект, разметку. Поисковик знает только адрес и то, что на этот адрес кто-то ссылается. Именно поэтому запрещённые в robots.txt страницы иногда всплывают в выдаче голой строкой без описания — система индексирует сам факт существования URL, опираясь на анкоры внешних ссылок.
| Свойство | robots.txt | Мета-тег robots |
|---|---|---|
| Что регулирует | Обход URL краулером | Индексирование и переход по ссылкам |
| Область действия | Весь хост целиком | Одна конкретная страница |
| Где размещается | Корень домена, /robots.txt | Секция head документа |
| Виден ли роботу без загрузки страницы | Да | Нет, нужен запрос страницы |
| Убирает ли страницу из индекса | Нет, не гарантированно | Да, после переобхода |
| Экономит ли краулинговый бюджет | Да, запрос не выполняется | Нет, страница всё равно скачивается |
| Применим к PDF, изображениям, XML | Да | Нет, только через заголовок X-Robots-Tag |
Синтаксис robots.txt построчно
Файл представляет собой обычный текст в кодировке UTF-8, лежащий строго по адресу вида https://example.ru/robots.txt. Он действует на конкретную комбинацию протокола, домена и порта. Файл с https-версии не распространяется на http-версию, а поддомен обязан иметь собственный файл — общий на весь сайт не существует. Это первая вещь, которую я проверяю, когда владелец говорит «у нас там всё закрыто, а оно индексируется»: закрыто на основном домене, а лезет с поддомена, где файла нет вовсе.
Содержимое разбито на группы. Группа начинается со строки User-agent и продолжается директивами до следующего User-agent. Робот выбирает ровно одну группу — ту, чьё имя точнее всего совпадает с его собственным, и остальные игнорирует полностью. Если для YandexBot есть отдельный блок, звёздочку он читать не станет, даже если в звёздочке лежат важные запреты.
- User-agent — имя робота. Звёздочка означает «все, для кого нет персональной группы». Регистр в имени не важен: Yandex, yandex и YANDEX равнозначны.
- Disallow — путь, запрещённый к обходу. Значение начинается со слэша и сравнивается с началом URL после домена.
- Allow — явное разрешение. Нужно, чтобы вырезать исключение внутри запрещённой ветки.
- Sitemap — абсолютный адрес карты сайта, включая протокол и домен. Директива межгрупповая: её видят все роботы независимо от того, в каком блоке она стоит.
- Clean-param — директива Яндекса, объявляющая незначащие GET-параметры. Позволяет не плодить запреты на каждую метку.
Комментарии начинаются с решётки и идут до конца строки. Пустая строка внутри группы её не разрывает, но лучше держать блоки цельными — читаемость экономит время при разборе инцидентов.
Шаблоны, регистр и порядок применения правил
В значениях путей работают два спецсимвола. Звёздочка заменяет любую последовательность символов, доллар фиксирует конец адреса. Строка Disallow: /*sort= запретит любой URL, где встречается такой параметр. Строка Disallow: /*.pdf$ закроет файлы, чей адрес заканчивается на .pdf, но не тронет /catalog/file.pdf?ref=mail, потому что доллар требует точного окончания.
Важная деталь: в конце каждого значения Disallow подразумевается звёздочка. Запись Disallow: /admin закрывает не только /admin/, но и /administrator и /admin-panel. Если нужен только каталог, пишите слэш явно: Disallow: /admin/.
Пути чувствительны к регистру. /Catalog/ и /catalog/ — разные правила. Сайты на связке nginx и Linux почти всегда различают регистр в URL, поэтому опечатка в одной букве превращает запрет в пустую строку.
Подробнее об этом — в статье «Файл robots.txt для сайта».
Когда один URL подходит под Allow и под Disallow одновременно, побеждает более длинное правило — по числу символов в значении. При равной длине предпочтение отдаётся разрешению. Проверим на примере интернет-магазина:
| Правила в файле | Проверяемый URL | Результат |
|---|---|---|
| Disallow: /catalog/ Allow: /catalog/hits/ |
/catalog/hits/tovar-1/ | Разрешён: Allow длиннее |
| Disallow: /catalog/ Allow: /catalog/hits/ |
/catalog/new/tovar-2/ | Запрещён: подходит только Disallow |
| Disallow: /*? Allow: /*?page= |
/catalog/?page=3 | Разрешён: Allow длиннее и точнее |
| Disallow: / Allow: / |
Любой URL | Разрешён: при равной длине выигрывает Allow |
| Disallow: | Любой URL | Разрешён: пустое значение запрета не создаёт |
Разница между Disallow: / и Disallow: (пустое значение) — самая дорогая опечатка в техническом SEO. Первая строка закрывает сайт целиком, вторая не закрывает ничего. Один символ, диаметрально противоположный смысл.
Что происходит, когда файла нет или он недоступен
Реакция поисковика на код ответа сервера прописана в спецификации и её полезно знать наизусть, потому что она объясняет странные всплески и провалы обхода.
- 200 и валидный текст — правила применяются как написано.
- 404 или любой другой 4xx — считается, что ограничений нет, обходится весь сайт. Отсутствие файла безопаснее битого файла.
- 5xx и таймауты — временный полный запрет обхода. Если сервер отдаёт пятисотку на robots.txt несколько суток, краулер сокращает активность по всему хосту. Отсюда типичная связка: переезд хостинга, кривой конфиг, обвал индексации через неделю.
- Редирект на другой домен — Яндекс и Google перейдут по цепочке, но правила будут применены к тому хосту, где файл лежал изначально. Плодить редиректы для robots.txt не стоит.
- Файл больше лимита — обрабатывается только начало, порядка 500 КБ. Всё, что дальше, отбрасывается. Гигантский файл на десятки тысяч строк — почти всегда признак того, что вместо правил там свалка.
Кэширование тоже влияет. Поисковики держат разобранный файл до суток, поэтому мгновенного эффекта от правки ждать не приходится. Ускорить чтение можно переобходом файла в панели вебмастера.
Из чего складывается продвижение сайта и как оно работает:
Мета-тег robots: полный набор значений
Тег ставится в секцию head и выглядит как строка вида meta name=»robots» content=»noindex, follow». Вместо robots можно указать конкретного робота — yandex или googlebot — и тогда правило подействует только на него. При наличии и общего, и адресного тега робот выполнит адресный.
| Значение | Что делает | Когда применять |
|---|---|---|
| index / noindex | Разрешает или запрещает включение страницы в базу поиска | noindex — для страниц, нужных людям, но бесполезных в выдаче |
| follow / nofollow | Разрешает или запрещает переход по ссылкам со страницы | nofollow — для страниц с большим объёмом пользовательских ссылок |
| none | Синоним noindex, nofollow | Когда нужно отсечь страницу полностью |
| all | Синоним index, follow | Значение по умолчанию, писать не обязательно |
| noarchive | Запрещает показ сохранённой копии | Часто меняющиеся данные, закрытые разделы |
| nosnippet | Убирает текстовое описание из сниппета | Крайне редко: снижает кликабельность |
| max-snippet:N | Ограничивает длину описания N символами | Платный контент, превью по подписке |
| max-image-preview | Задаёт размер картинки в сниппете: none, standard, large | Медиапроекты, галереи |
| noimageindex | Запрещает индексировать изображения со страницы | Авторские фото, лицензионные материалы |
| unavailable_after | Дата, после которой страница выпадает из индекса | Акции, мероприятия с фиксированной датой |
| noyaca | Запрещает Яндексу брать описание из Яндекс.Каталога | Устаревшее, оставлено для совместимости |
Значения перечисляются через запятую в одном теге. Два отдельных тега с противоречащими значениями дают непредсказуемый результат: поисковик выбирает более строгое. Если на странице стоит и noindex, и index, страница будет закрыта.
Отдельно отмечу связку noindex, follow. Она нужна там, где страница сама по себе в выдаче не требуется, но служит перекрёстком для обхода: страницы пагинации в некоторых схемах, теговые подборки, промежуточные разделы каталога. Робот пройдёт насквозь и подберёт вложенные адреса, а сама промежуточная страница в базу не попадёт.
X-Robots-Tag для файлов, где нет head
Мета-тег живёт в HTML. PDF-документы, изображения, архивы, XML-фиды и любые не-HTML ответы места для него не имеют. Для них существует HTTP-заголовок X-Robots-Tag с тем же набором значений.
Тему разбирал отдельно: «Мета тег description как правильно заполнять».
Заголовок отдаёт сервер. На Apache это делается через .htaccess с директивой Header set для нужного типа файлов, на nginx — через add_header в блоке location. Синтаксис значений идентичен мета-тегу: noindex, nofollow, noarchive и всё остальное работает так же.
Самый частый практический сценарий — коммерческие предложения и прайсы в PDF, которые незачем держать в выдаче. Второй сценарий — служебные XML-выгрузки для маркетплейсов. Третий — тестовый поддомен, где заголовок с noindex вешают на весь хост одной строкой в конфиге, не трогая шаблоны.
Важный нюанс: заголовок, как и мета-тег, требует, чтобы робот получил ответ сервера. Если файл дополнительно закрыт в robots.txt, заголовок останется непрочитанным.
Конфликт запретов: почему закрытая страница висит в выдаче
Разберём самый частый инцидент. Владелец обнаруживает в поиске страницу корзины или личного кабинета, пишет в robots.txt строку Disallow: /cart/ и ждёт, что через неделю адрес исчезнет. Проходит месяц, адрес на месте, только описание сменилось на текст вроде «описание недоступно из-за ограничений в robots.txt».
Механика простая. До запрета страница была обойдена и попала в базу. После запрета робот перестал её запрашивать — а значит, перестал получать любую информацию о ней, включая указание на удаление. Запись в индексе законсервировалась. Поисковик видит внешние и внутренние ссылки на этот URL, считает его существующим и продолжает показывать по узким запросам.
Если нужна помощь по теме — обучение SEO-продвижению.
Правильный порядок обратный, и он строится в два такта:
- Снять запрет в robots.txt, чтобы робот снова получил доступ к странице.
- Поставить на страницу мета-тег noindex или отдать заголовок X-Robots-Tag с тем же значением.
- Дождаться переобхода. Ускорить его можно отправкой URL на переобход в Яндекс.Вебмастере и через инструмент проверки URL в Google Search Console.
- Убедиться, что страница выпала из выдачи, и только после этого — если нужно экономить бюджет обхода — вернуть запрет в robots.txt.
Для срочных случаев в обеих панелях есть инструмент удаления URL. В Яндексе он убирает адрес из выдачи в течение суток при условии, что страница отдаёт 404, 403 или закрыта запретом. В Google удаление временное, порядка полугода, и служит именно затычкой на время, пока настраивается постоянное решение.
Смежный материал по теме — «Мета тег title как правильно заполнять».
Ошибки синтаксиса, которые встречаются чаще всего
Ниже список проблем, которые я нахожу на аудитах регулярно. Порядок примерно соответствует частоте.
| Ошибка | Как выглядит | Последствие |
|---|---|---|
| Забытый запрет с разработки | Disallow: / в группе для всех | Полное выпадение сайта из индекса за одну-две недели |
| Относительный адрес карты | Sitemap: /sitemap.xml | Директива игнорируется, карта не подхватывается |
| Закрыты CSS и JS | Disallow: /wp-content/ или /assets/ | Робот не может отрисовать страницу и оценить мобильную версию |
| Запрет обхода вместо noindex | Disallow на страницу, которую нужно убрать из поиска | Страница остаётся в выдаче без описания |
| Отдельная группа для Яндекса без общих правил | Блок User-agent: Yandex дублирует не все запреты | Яндекс обходит то, что закрыто только в звёздочке |
| Пробел перед двоеточием | Disallow : /admin/ | Строка не распознаётся и пропускается |
| Кириллица в путях без кодирования | Disallow: /каталог/ | Правило не совпадает с реальным URL в percent-encoding |
| BOM в начале файла | Невидимые байты перед User-agent | Первая директива теряется |
| Несколько строк User-agent подряд без директив | Пустые группы | Робот берёт неверный блок правил |
| Запрет всего с параметрами | Disallow: /*? | Закрывается работающая фильтрация и пагинация с полезным трафиком |
Отдельная категория — правила по умолчанию от CMS. Многие движки кладут в корень заготовку, написанную под структуру десятилетней давности. WordPress-сборки до сих пор нередко закрывают папку с темой, где лежат стили; самописные системы закрывают весь /index.php, через который иногда идёт вся генерация страниц. Чужой файл, скопированный целиком, — та же болезнь: пути в нём относятся к другому движку.
Порядок проверки после каждой правки
Правку robots.txt и мета-тегов нельзя выкладывать вслепую. Проверка занимает пять минут и делится на четыре шага.
- Прочитать файл глазами по адресу /robots.txt. Убедиться, что отдаётся код 200 и текст тот, который вы редактировали, а не старая версия из кэша CDN.
- Прогнать через анализатор в Яндекс.Вебмастере. В разделе инструментов есть проверка robots.txt: вставляете список важных URL и получаете вердикт «разрешён» или «запрещён строкой номер N». Это единственный способ увидеть, какое именно правило сработало.
- Проверить URL в Google Search Console. Инструмент проверки URL показывает и доступность для обхода, и обнаруженные на странице мета-теги, и итоговое решение по индексированию.
- Посмотреть заголовки ответа. Запрос curl с ключом -I по адресу страницы покажет, не приходит ли неожиданный X-Robots-Tag от сервера или плагина. Такое случается после установки модулей безопасности.
Список URL для проверки составляйте заранее и держите постоянным: главная, две-три посадочные под коммерческие запросы, карточка товара, страница услуги, свежая статья, страница пагинации, файл стилей, файл скриптов. Если все девять адресов ведут себя ожидаемо, правка безопасна.
Частые вопросы про robots.txt и мета-тег
Нужен ли robots.txt маленькому сайту на десять страниц? Как минимум ради строки Sitemap и запрета служебных адресов вроде форм и результатов внутреннего поиска. Отсутствие файла не ошибка, но управлять обходом вы не сможете.
Передаётся ли вес по ссылкам с закрытой в robots.txt страницы? Нет. Робот на страницу не заходит и её ссылок не видит. Если задача — сохранить проход веса, но убрать страницу из поиска, используйте noindex, follow вместо запрета обхода.
Влияет ли nofollow в мета-теге на внешние ссылки? Значение действует на все ссылки страницы разом — и внутренние, и внешние. Точечно закрывать отдельные ссылки нужно атрибутом rel у самой ссылки, а не мета-тегом.
Через сколько времени сработает noindex? После ближайшего обхода страницы. Для часто посещаемых разделов это дни, для глубоко вложенных — недели. Переобход по запросу в панели вебмастера сокращает срок.
Можно ли закрыть от индексации часть текста на странице? В Яндексе исторически существовал парный тег noindex внутри тела документа, но полагаться на него как на инструмент управления выдачей не стоит: Google его не понимает, а логика ранжирования Яндекса давно не сводится к простому исключению фрагмента.
Что делать с фильтрами в каталоге? Комбинации, под которые есть спрос, оставлять открытыми и оптимизировать. Мусорные пересечения закрывать не запретом обхода, а каноническим адресом либо мета-тегом noindex, follow — так вы не теряете внутренний вес.
Обязательно ли дублировать группу для Яндекса? Отдельная группа нужна только под особые правила, например Clean-param. Если правила одинаковые, достаточно одной группы со звёздочкой — и это надёжнее, потому что нечему рассинхронизироваться.
Коротко
- robots.txt запрещает обход, мета-тег robots запрещает индексирование. Первое действует до загрузки страницы, второе — только после.
- Чтобы убрать страницу из поиска, её нужно оставить открытой для робота и закрыть мета-тегом noindex либо заголовком X-Robots-Tag.
- При конфликте Allow и Disallow побеждает более длинное правило; при равной длине — разрешение. Пустой Disallow не запрещает ничего, Disallow: / закрывает всё.
- Код 5xx на robots.txt поисковик трактует как полный запрет обхода, код 404 — как полное разрешение.
- Для PDF, изображений и XML мета-тег недоступен, ограничения задаются заголовком X-Robots-Tag на уровне сервера.
- Каждая правка проверяется анализатором в Вебмастере по фиксированному списку URL, а не выкладывается на веру.
Если сомневаетесь, что обход и индексация на вашем проекте настроены верно, приходите на бесплатную SEO-консультацию: посмотрим файл, мета-теги и заголовки ответа сервера вместе и разберём, какие страницы у вас закрыты по ошибке, а какие открыты зря.
Увеличьте позиции и продажи вашего сайта
Профессиональное SEO-продвижение с гарантией результата. Выберите подходящую услугу:
Остались вопросы по продвижению?
Меня зовут Анатолий Кузнецов, я SEO-оптимизатор с 20-летним стажем. Разберу ваш сайт, отвечу на вопросы и подскажу, что улучшить для роста позиций в Яндексе и Google.
Связаться со мной → Старт
 Стандарт
 Премиум



Комментарии
Виктор Хвалынский
Полгода держали в robots.txt запрет на раздел с отзывами и не могли понять, почему он висит в выдаче с пустым описанием. Прочитал про два такта — снять запрет, поставить noindex — и наконец сошлось. Вопрос: сколько ждать между тактами, чтобы не вернуть запрет раньше времени?
Анатолий Кузнецов автор
Ориентируйтесь не на календарь, а на факт переобхода. После снятия запрета отправьте адреса на переобход в Вебмастере и параллельно смотрите в логах сервера, приходил ли робот на эти URL и с каким кодом ответа ушёл. Как только в логах видно посещение уже после установки noindex, дальше остаётся ждать выпадения из выдачи — обычно это одна-три недели. Возвращать запрет в robots.txt я советую только если раздел действительно съедает заметную долю обхода: на сайте до нескольких тысяч страниц выгода нулевая, а риск снова законсервировать индекс есть. Проще оставить страницы открытыми с постоянным noindex.
Оксана Цветкова
Про пробел перед двоеточием — прямо про нас. Программист правил файл через панель хостинга, редактор подставил лишние символы, и три строки запретов просто перестали существовать. Нашли только когда в индекс полезли страницы печати.
Геннадий Чаплыгин
Не соглашусь насчёт правила «более длинное побеждает». У меня Allow: /catalog/ и Disallow: /catalog/filter/ — по вашей логике фильтр закрыт, потому что запрет длиннее. Но Яндекс в анализаторе показывает, что часть адресов фильтра ему разрешена. Где подвох?
Анатолий Кузнецов автор
Подвох почти наверняка в том, что вы смотрите не на ту группу правил. Проверьте, нет ли в файле отдельного блока User-agent: Yandex — если он есть, робот читает только его и ваши строки из звёздочки просто не применяет. Второй вариант: адреса фильтра начинаются не с /catalog/filter/, а, скажем, с /catalog/?filter= — тогда под запрет они не подпадают вовсе, потому что сравнение идёт по началу строки. Возьмите конкретный разрешённый URL, вставьте в анализатор robots.txt в Вебмастере, и он покажет номер строки, которая дала вердикт. Это снимает спор за минуту, спорить с логами и инструментом бесполезно.
Марина Хренова
Спасибо за таблицу с кодами ответа. У нас как раз был случай: хостинг лежал два дня, отдавал 503 на всё, включая robots.txt. Обход упал и восстанавливался ещё недели три. Теперь понятно, что это была не случайность.
Пётр Цепелев
Вопрос по X-Robots-Tag. У нас прайсы в PDF лежат на поддомене files, и хочется закрыть их разом. Правильно ли будет повесить заголовок на весь поддомен через nginx, или лучше отдельным правилом только на расширение pdf?
Анатолий Кузнецов автор
Если на поддомене лежат только файлы для скачивания и никаких HTML-страниц, которые вы хотите видеть в поиске, вешайте заголовок на весь хост — так надёжнее и не забудется при добавлении новых форматов. Если там же лежат картинки, которые вы хотели бы видеть в поиске по изображениям, делайте location по расширению и закрывайте только pdf, doc и xls. В обоих случаях после настройки обязательно проверьте реальный ответ сервера запросом curl с ключом -I: заголовок должен приходить в каждом ответе, а не только на первом запросе. И не закрывайте этот поддомен ещё и в robots.txt — иначе робот не увидит сам заголовок, и файлы застрянут в индексе адресами без описания.
Лариса Чудинова
Меня смущает совет открывать CSS и JS. Разработчик говорит, что это лишняя нагрузка на сервер и лишний расход трафика при обходе. Аргумент про отрисовку он не принимает, потому что «поисковик и так текст видит».
Анатолий Кузнецов автор
Аргумент разработчика был верен лет пятнадцать назад, когда индексатор действительно работал с сырым HTML. Сейчас страница рендерится: браузерный движок применяет стили и выполняет скрипты, и уже по итоговой картинке оценивается, что видит пользователь, помещается ли контент на экран мобильного и не перекрыт ли текст. Если стили закрыты, робот получает поломанную страницу — иногда с текстом, который в реальности скрыт, иногда наоборот. Проще всего снять спор наглядно: в Google Search Console откройте проверку URL и посмотрите скриншот отрисованной страницы. Когда разработчик увидит вместо своего дизайна голый список ссылок, вопрос про нагрузку закроется сам. Нагрузка при этом мизерная: файлы стилей кэшируются и запрашиваются редко.
Игорь Холин
Полезно про кириллицу в путях. У нас каталог с русскими ЧПУ, и запреты в robots.txt никогда не срабатывали. Никто не догадался, что писать надо в закодированном виде, а не так, как в браузерной строке.
Светлана Чечулина
А как быть со страницами благодарности после отправки формы? Сейчас они закрыты в robots.txt, но в статистике вижу, что переходы из поиска на них всё-таки бывают. Значит, где-то они всё же в индексе.
Анатолий Кузнецов автор
Ровно тот случай, ради которого написан раздел про конфликт запретов. Страница попала в базу до того, как вы её закрыли, а после запрета робот перестал её проверять и запись законсервировалась. Уберите строку из robots.txt, поставьте в шаблон страницы благодарности мета-тег с noindex, follow и отправьте адрес на переобход. Заодно проверьте, нет ли на страницу внутренних ссылок из меню или карты сайта — если она в sitemap.xml, поисковик будет считать её значимой. И отдельно посмотрите, не приходят ли эти переходы по брендовому запросу с адресом страницы: иногда трафик на «спасибо» идёт из закладок и из мессенджеров, а система статистики относит его к поиску по ошибке разметки переходов.
Дмитрий Хусаинов
Список из девяти URL для регулярной проверки забрал себе. Раньше проверяли только главную и удивлялись, откуда берутся сюрпризы после релизов.
Наталья Цитович
Хотелось бы уточнить про Clean-param. Это ведь только Яндекс. Что делать с теми же метками для Google — закрывать их через Disallow или полагаться на канонический адрес?
Аркадий Чертков
Отдельная группа для Яндекса действительно опасная штука. У нас в неё год назад добавили пару строк, а в общую забыли, и в итоге Яндекс обходил тестовые адреса, которых Google не видел. Разница в индексе была в полторы тысячи страниц.
Юлия Хомич
Про поддомены с отдельным robots.txt — больная тема. Разработчики подняли демо-версию на dev-поддомене, файл туда не положили, и через месяц демо начало конкурировать с боевым сайтом по части запросов. Пришлось закрывать доступ по паролю.